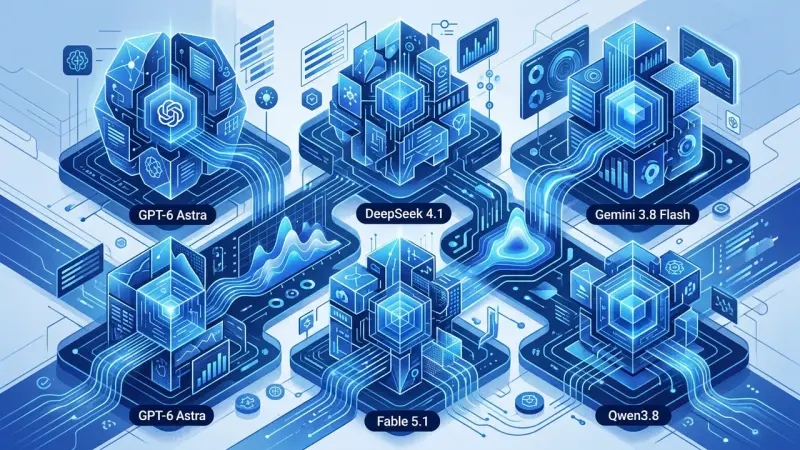
So Sánh GPT-6 Astra, DeepSeek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8
 Tuấn Lê
Chi phí vận hành token tăng vọt cùng yêu cầu khắt khe về độ chính xác khi triển khai các hệ thống Agentic AI khiến việc lựa chọn nền tảng trở thành bài toán sống còn. Phân tích đối chiếu giữa GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 đem lại cái nhìn toàn diện về năng lực tính toán, mức tiêu hao tài nguyên và kiến trúc suy luận của thế hệ mô hình tiên tiến nhất năm 2026.
Việc đánh giá chính xác từng chỉ số kỹ thuật của GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 giúp đội ngũ kỹ sư tối ưu hóa hệ thống backend, giảm thiểu hiện tượng ảo giác và kiểm soát ngân sách vận hành ở quy mô lớn.
Bối Cảnh Cuộc Đua Frontier Model: Bước Chuyển Từ Reasoning Sang Agentic Autonomy
Các mô hình ngôn ngữ lớn đã vượt qua giai đoạn cạnh tranh đơn thuần về số lượng tham số hay khả năng hoàn thành câu. Trọng tâm chuyển dịch hoàn toàn sang năng lực tự trị cấp hệ thống (Agentic Autonomy), nơi AI tự hoạch định kế hoạch đa bước, sử dụng công cụ ngoại vi và sửa lỗi mã nguồn theo vòng lặp phản hồi khép kín.
Các tổ chức công nghệ không còn hài lòng với những câu trả lời dạng văn bản tĩnh. Nhu cầu thực tế đòi hỏi AI phải trực tiếp can thiệp vào quy trình CI/CD, phân tích báo cáo tài chính đa chiều và điều phối luồng công việc phức hợp mà không cần sự can thiệp liên tục của con người.
5 Đại diện tiêu biểu trong hệ sinh thái AI toàn cầu
Thị trường chứng kiến sự phân hóa rõ nét giữa các phòng lab nghiên cứu hàng đầu. Nhóm mô hình đại diện gồm có GPT-6 Astra của OpenAI, DeepSeek 4.1 từ cộng đồng mã nguồn mở, Gemini 3.8 Flash thuộc hệ sinh thái Google DeepMind, Claude Fable 5.1 của Anthropic và Qwen 3.8 từ tập đoàn Alibaba.
Mỗi đại diện mang một triết lý thiết kế riêng biệt nhằm giải quyết các bài toán biên khác nhau. Khảo sát danh mục GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 phản ánh sự cân bằng giữa hiệu suất suy luận cực hạn và chi phí biên tế trên từng triệu token xử lý.
Khung tiêu chí đánh giá kỹ thuật và hiệu năng
Để đảm bảo tính khách quan, khung đo lường kỹ thuật được thiết lập dựa trên năm trục chỉ số cốt lõi: Cửa sổ ngữ cảnh khả dụng (Effective Context Window), Thông lượng tạo token (Throughput tính bằng TPS), Độ trễ tạo token đầu tiên (Time to First Token - TTFT), Chi phí API kết hợp TCO hạ tầng, và Tỷ lệ hoàn thành tác vụ logic không giám sát.
Đội ngũ phát triển có thể tham khảo thêm các bộ khung chỉ lệnh tối ưu tại thư viện prompt AI để tối đa hóa hiệu năng trích xuất dữ liệu của từng mô hình tương ứng.
Bảng Đối Soát Tổng Thể Thông Số Kỹ Thuật Và Kiến Trúc Nền Tảng
Dữ liệu kỹ thuật công bố năm 2026 cho thấy sự tiến hóa vượt bậc trong việc áp dụng cấu trúc Mixture-of-Experts (MoE) thưa thớt kết hợp cơ chế chú ý biến thiên (Dynamic Multi-Head Latent Attention). Việc so sánh trực diện cấu hình phần cứng và thông số suy luận của GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 cung cấp cơ sở vững chắc cho các quyết định kiến trúc hệ thống.
Đối chiếu Context Window, Throughput và cấu trúc MoE
Dưới đây là bảng tổng hợp các thông số vận hành then chốt được ghi nhận trên môi trường thử nghiệm tiêu chuẩn:
| Mô hình | Kiến trúc mạng | Cửa sổ Context | Tốc độ (TPS) | Hỗ trợ Đa thể thức | Giấy phép |
|---|---|---|---|---|---|
| GPT-6 Astra | Dense-MoE Hybrid | 2.000.000 tokens | 75 | Text, Code, Audio, Video, Screen | Thương mại đóng |
| DeepSeek 4.1 | Sparse MoE (16/128 Active) | 512.000 tokens | 120 | Text, Code, Vision | Mã nguồn mở / API |
| Gemini 3.8 Flash | Native MoE Chú ý nhẹ | 4.000.000 tokens | 210 | Full Multimodal Native | Thương mại đóng |
| Claude Fable 5.1 | Deep Attention MoE | 1.000.000 tokens | 95 | Text, Code, Vision, Docs | Thương mại đóng |
| Qwen 3.8 | Dense MoE lai hợp | 512.000 tokens | 135 | Text, Code, Vision, Audio | Mã nguồn mở / API |
Phân tích dữ liệu thực tế từ nhóm GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 cho thấy Gemini 3.8 Flash dẫn đầu tuyệt đối về tốc độ tạo token cũng như khả năng nhận diện ngữ cảnh siêu dài, trong khi DeepSeek 4.1 duy trì thế mạnh mã nguồn mở hiệu năng cao.
Khác biệt trong cơ chế Native Reasoning và xử lý đa thể thức
Cơ chế phân bổ tài nguyên tính toán (Compute Budget Allocation) trong pha suy luận định hình sự khác biệt giữa các dòng mô hình. GPT-6 Astra tích hợp chuỗi suy nghĩ nội tại (Native Chain-of-Thought) có khả năng tự động giãn nở thời gian xử lý dựa trên độ khó của prompt.
Trái lại, Claude Fable 5.1 sử dụng kiến trúc phân luồng logic song song, cho phép xác minh tính nhất quán ngữ nghĩa trước khi xuất token cuối cùng. Điều này giúp giảm thiểu sai số trong các văn bản mang tính ràng buộc pháp lý hoặc cấu trúc code phức tạp.
Khảo Sát Benchmark Tiêu Chuẩn: ARC-AGI-3, DeepSWE Và FrontierMath
Các bài kiểm tra truyền thống như MMLU hay GSM8K đã bão hòa khi hầu hết các mô hình đều chạm ngưỡng trần trên 95%. Để đánh giá thực chất khả năng giải quyết vấn đề mới, các kỹ sư hiện nay tập trung vào ba bộ benchmark chuyên biệt: ARC-AGI-3, DeepSWE và FrontierMath.
Năng lực tư duy trừu tượng và giải toán đa bước trên FrontierMath
FrontierMath thử nghiệm năng lực nghiên cứu toán học thuần túy với các bài toán mở chưa từng được công bố công khai trên Internet. Các mô hình thuộc nhóm GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 thể hiện mức độ phân hóa kỹ thuật rất sâu sắc.
GPT-6 Astra thiết lập kỷ lục với 41,2% điểm giải quyết chính xác, bám sát là Claude Fable 5.1 với 38,7%. Qwen 3.8 gây bất ngờ lớn khi đạt 33,5%, vượt qua nhiều biến thể tinh chỉnh khác nhờ thừa hưởng nền tảng huấn luyện dữ liệu toán học chuyên sâu từ Viện Nghiên cứu Alibaba DAMO.
Hiệu suất kỹ thuật phần mềm và sửa lỗi tự động trên DeepSWE
DeepSWE mô phỏng môi trường phát triển phần mềm doanh nghiệp, yêu cầu AI giải quyết các GitHub Issue thực tế, từ tái tạo lỗi, định vị file đến viết test case và tạo Pull Request đạt chuẩn CI/CD.
- Claude Fable 5.1: Đạt tỷ lệ giải quyết thành công 64,8%, giữ độ sạch của codebase cao nhất và không tạo ra xung đột mã thừa.
- DeepSeek 4.1: Đạt 59,2%, dẫn đầu nhóm mã nguồn mở nhờ khả năng tự viết unit test kiểm thử ngược logic trước khi hoàn tất commit.
- GPT-6 Astra: Đạt 63,5%, sở hữu khả năng cấu trúc lại toàn bộ module phức tạp trong kiến trúc Microservices mà không làm vỡ các dependency liên quan.
- Gemini 3.8 Flash: Đạt 51,4%, xử lý cực nhanh các tác vụ refactor cơ bản nhưng có xu hướng bỏ qua một số corner cases trong hệ thống legacy code.
Phân Tích Chi Tiết Từng Mô Hình: Điểm Mạnh Kỹ Thuật Và Hạn Chế Cốt Lõi
Mỗi công cụ đều được tôi luyện cho các mục đích triển khai riêng biệt. Việc so sánh nhóm GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 chỉ thực sự có giá trị khi đặt vào môi trường vận hành sản xuất (production) với các ràng buộc về tài nguyên cụ thể.
GPT-6 Astra: Đầu tàu suy luận Agentic và khả năng điều phối hệ thống phức hợp
GPT-6 Astra khẳng định vị thế dẫn đầu trong các tác vụ tự chủ dài hạn. Mô hình có khả năng duy trì trạng thái ngữ cảnh liên tục qua hàng nghìn bước hành động, tự gọi API ngoài, tổng hợp dữ liệu phân tán và hoàn thành báo cáo chuyên sâu mà không bị phân tán mục tiêu ban đầu.
Hạn chế lớn nhất của nền tảng này nằm ở chi phí vận hành đắt đỏ và độ trễ cao khi kích hoạt cơ chế suy luận sâu. Các tác vụ cần phản hồi tức thì dưới 500ms không phải là đất diễn phù hợp cho GPT-6 Astra.
DeepSeek 4.1: Bước nhảy vọt hiệu suất mã nguồn mở và tối ưu hóa suy luận
DeepSeek 4.1 tiếp tục chứng minh sức mạnh của kiến trúc mã nguồn mở tối ưu. Nhờ thuật toán nén trọng số và phân luồng MoE tinh chỉnh, mô hình có thể chạy suy luận mượt mà trên cụm máy chủ nội bộ mà không cần đầu tư hạ tầng phần cứng siêu đắt đỏ.
Khả năng tự chủ hạ tầng (On-premise deployment) giúp DeepSeek 4.1 trở thành ưu tiên hàng đầu của các doanh nghiệp tài chính, y tế và cơ quan nhà nước có yêu cầu bảo mật dữ liệu tuyệt đối theo quy định pháp lý nghiêm ngặt.
Gemini 3.8 Flash: Tốc độ xử lý siêu tốc và phân tích video/audio thời gian thực
Gemini 3.8 Flash đại diện cho chuẩn mực tốc độ trong thế hệ mô hình mới. Thời gian phản hồi TTFT chỉ dao động từ 120ms đến 180ms, kết hợp thông lượng 210 TPS giúp mô hình trở thành trái tim của các hệ sinh thái trợ lý giọng nói tương tác thời gian thực.
Cửa sổ ngữ cảnh 4 triệu token cho phép nạp trực tiếp toàn bộ video ghi hình 3 tiếng hoặc cơ sở dữ liệu nhật ký hệ thống (log files) khổng lồ để phát hiện sự cố hạ tầng chỉ trong vài giây.
Claude Fable 5.1: Chuẩn mực logic ngữ cảnh sâu và độ an toàn cấu trúc code
Claude Fable 5.1 nổi bật với khả năng kiểm soát văn phong tự nhiên, sự chuẩn xác trong việc tuân thủ các quy chuẩn lập trình và khả năng suy luận logic không ảo giác. Khi xử lý các tài liệu pháp lý phức tạp, Fable 5.1 duy trì độ chính xác câu chữ ở mức tuyệt đối.
Qwen 3.8: Sức mạnh xử lý đa ngôn ngữ và lợi thế triển khai hạ tầng doanh nghiệp
Qwen 3.8 phát huy tối đa ưu thế trong xử lý các ngôn ngữ khu vực Châu Á, bao gồm tiếng Việt và tiếng Trung. Khả năng hiểu sâu sắc cấu trúc ngữ nghĩa đa tầng bản địa giúp Qwen 3.8 vượt trội trong các tác vụ dịch thuật tài liệu kỹ thuật, xử lý hợp đồng thương mại và chăm sóc khách hàng tự động.
Tính linh hoạt khi finetuning cũng là điểm cộng lớn. Doanh nghiệp có thể dễ dàng đóng gói Qwen 3.8 thành các adapter chuyên biệt phục vụ từng phòng ban chức năng với mức chi phí đào tạo thấp.
So Sánh Chi Phí API Và TCO Doanh Nghiệp Trên 1 Triệu Token
Tối ưu hóa tổng chi phí sở hữu (Total Cost of Ownership - TCO) là yêu cầu tiên quyết khi chuyển đổi dự án từ giai đoạn thử nghiệm (PoC) sang môi trường phục vụ triệu người dùng. Khi đặt bàn cân kinh tế giữa GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8, bức tranh ngân sách bộc lộ sự phân hóa rõ rệt.
Bảng đối chiếu đơn giá Input/Output token và chi phí Batch API
Mức giá niêm yết chính thức trên các cổng API thương mại và nền tảng đám mây lớn được ghi nhận như sau:
| Mô hình | Input ($/1M Tokens) | Output ($/1M Tokens) | Batch Discount | Cached Input Discount |
|---|---|---|---|---|
| GPT-6 Astra | $3.50 | $14.00 | 50% | 80% |
| DeepSeek 4.1 (Cloud API) | $0.28 | $1.10 | 40% | 75% |
| Gemini 3.8 Flash | $0.15 | $0.60 | 50% | 75% |
| Claude Fable 5.1 | $2.80 | $11.20 | 50% | 80% |
| Qwen 3.8 (Cloud API) | $0.35 | $1.40 | 50% | 70% |
Dữ liệu biểu thị Gemini 3.8 Flash có mức chi phí API cạnh tranh nhất phân khúc thương mại đóng, trong khi DeepSeek 4.1 là phương án tiết kiệm nhất cho các tác vụ cần năng lực suy luận cao. Sự chênh lệch chi phí giữa GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 lên đến hơn 15 lần ở đầu ra Output.
Chi phí hạ tầng On-premise so với Cloud API: Bài toán điểm hòa vốn
Với các doanh nghiệp có lưu lượng truy cập lớn (vượt ngưỡng 100 triệu token mỗi ngày), việc tự vận hành DeepSeek 4.1 hoặc Qwen 3.8 trên cụm máy chủ 8x H200/B200 nội bộ mang lại hiệu quả kinh tế vượt bậc.
Công thức tính toán điểm hòa vốn hạ tầng (Break-even Point) được xác định như sau:
Điểm hòa vốn (Tháng) = Chi phí đầu tư phần cứng ban đầu / (Chi phí Cloud API hàng tháng - Chi phí vận hành điện, làm mát, bảo trì)Thực tế triển khai cho thấy các tổ chức tiêu thụ trên 3 tỷ token/tháng sẽ đạt điểm hòa vốn chỉ sau 4 đến 6 tháng vận hành hệ thống máy chủ riêng.
Ma Trận Lựa Chọn Mô Hình Phù Hợp Cho Từng Kịch Bản Sử Dụng
Không có một mô hình duy nhất nào tối ưu cho mọi nghiệp vụ. Một kiến trúc AI hiện đại đòi hỏi sự kết hợp linh hoạt các thành viên trong nhóm GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 vào các vị trí phù hợp trong pipeline xử lý dữ liệu của doanh nghiệp.
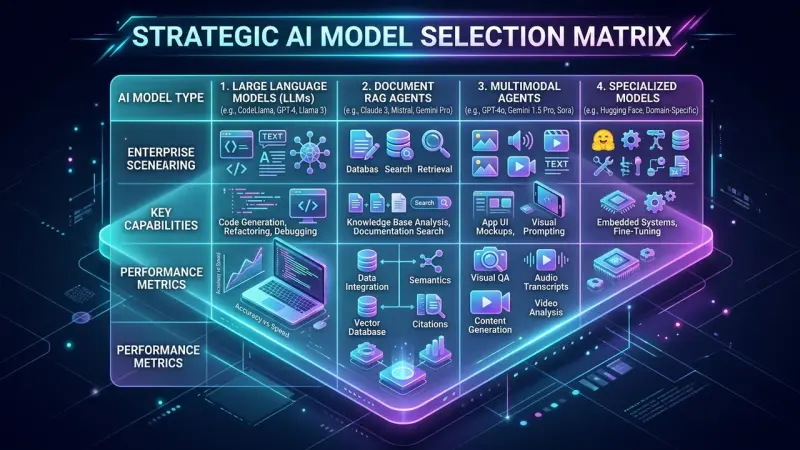
Kịch bản 1: Pipeline phát triển phần mềm tự động và rà soát lỗ hổng
Quy trình tối ưu hóa code đòi hỏi sự phối hợp nhịp nhàng giữa hai vai trò: Kiến trúc sư trưởng và Kỹ sư kiểm thử chuyên sâu.
- Lập kế hoạch kiến trúc: Giao phó cho GPT-6 Astra phân tích yêu cầu phần mềm, lập sơ đồ cơ sở dữ liệu và thiết kế giao diện API tổng thể.
- Sinh mã module: Phân phối cho Claude Fable 5.1 thực hiện viết mã chi tiết từng controller và service nhằm đảm bảo cấu trúc sạch sẽ, an toàn tuyệt đối về bảo mật.
- Kiểm thử tự động: Sử dụng DeepSeek 4.1 chạy các vòng lặp sinh unit test, quét mã phát hiện lỗ hổng SQL Injection và logic flow errors.
Kịch bản 2: Hệ thống RAG doanh nghiệp và trích xuất tài liệu quy mô lớn
Để tối ưu bài toán trích xuất tri thức từ hàng triệu trang tài liệu nội bộ trên nền tảng thanhtuan.vn, kiến trúc lai phân tầng mang lại hiệu suất vượt trội.
Gemini 3.8 Flash đảm nhận vai trò bộ lọc sơ bộ (Reranker) và tóm tắt ngữ cảnh siêu nhanh nhờ chi phí đầu vào cực thấp. Với các văn bản song ngữ hoặc tài liệu thương mại đặc thù tại thị trường nội địa, Qwen 3.8 tiếp quản giai đoạn phân tích sâu và xuất báo cáo có cấu trúc JSON chính xác.
Kịch bản 3: Trợ lý thoại tương tác tức thì và Agent điều khiển giao diện
Trong các ứng dụng tương tác giọng nói trực tiếp qua điện thoại hoặc web, độ trễ phản hồi là yếu tố sống còn. Gemini 3.8 Flash được dùng làm mô hình đàm thoại chính để duy trì phản hồi dưới 200ms.
Khi người dùng kích hoạt các yêu cầu phức tạp như tra cứu giao dịch ngân hàng hoặc hủy đơn hàng, hệ thống sẽ gọi cơ chế Function Calling sang GPT-6 Astra chạy ngầm để đảm bảo tính xác thực và an toàn nghiệp vụ.
Kiến Trúc Dynamic Model Routing: Tối Ưu Chi Phí Lên Đến 65%
Thay vì gửi toàn bộ dữ liệu vào một mô hình duy nhất, các kỹ sư trưởng xây dựng hệ thống Cổng điều hướng thông minh (Dynamic Model Router). Kỹ thuật này phân loại prompt đầu vào theo độ phức tạp để chuyển tuyến tới mô hình phù hợp nhất trong dàn GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8.
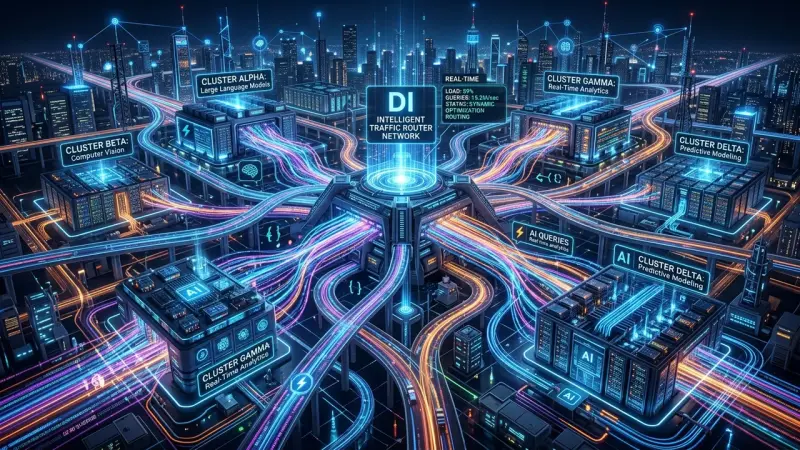
Thiết lập bộ phân loại ý định (Intent Classifier) và Router Gateway
Bộ phân loại ý định sử dụng một mô hình cực nhỏ (như DeBERTa-v3 hoặc LLM 1B tham số) để chấm điểm độ phức tạp của câu lệnh trên thang điểm từ 1 đến 10.
- Mức 1 - 3 (Tác vụ cơ bản): Chuyển tuyến trực tiếp đến Gemini 3.8 Flash hoặc Qwen 3.8 để xử lý nhanh với mức chi phí tối thiểu.
- Mức 4 - 7 (Tác vụ trung bình): Định tuyến sang DeepSeek 4.1 để giải quyết các bài toán viết code, trích xuất thực thể hoặc tóm tắt tài liệu kỹ thuật.
- Mức 8 - 10 (Tác vụ suy luận chuyên sâu): Kích hoạt GPT-6 Astra hoặc Claude Fable 5.1 để giải bài toán logic phức tạp, thiết kế hệ thống hoặc phân tích pháp lý.
Cơ chế Fallback và Caching phân tầng bảo đảm SLA hệ thống
Hệ thống sản xuất luôn đối mặt với nguy cơ nghẽn mạng hoặc vượt ngưỡng giới hạn tần suất (Rate Limit) từ nhà cung cấp API. Thiết lập cơ chế dự phòng (Fallback Hierarchy) giúp duy trì tính sẵn sàng 99,99% theo cam kết SLA.
Khi API GPT-6 Astra phản hồi mã lỗi 429 hoặc 503, Gateway sẽ tự động chuyển hướng yêu cầu sang Claude Fable 5.1 chỉ trong 50ms. Đồng thời, tầng Semantic Cache tại Redis lưu trữ các kết quả phổ biến để phản hồi ngay lập tức cho người dùng mà không cần tiêu tốn token tính toán.
Giải Đáp Thắc Mắc Kỹ Thuật Khi Triển Khai (FAQ)
Mô hình nào trong nhóm hỗ trợ fine-tuning hiệu quả nhất cho dữ liệu tiếng Việt?
Qwen 3.8 là lựa chọn hàng đầu cho các tác vụ fine-tuning tiếng Việt nhờ tập dữ liệu tiền huấn luyện đa ngôn ngữ phong phú và cấu trúc từ điển token (tokenizer) được tối ưu hóa riêng cho các ngôn ngữ ngữ hệ Nam Á và Đông Nam Á. DeepSeek 4.1 cũng là phương án thay thế xuất sắc nếu doanh nghiệp ưu tiên tác vụ lập trình song ngữ.
Nên ưu tiên Gemini 3.8 Flash hay DeepSeek 4.1 cho các tác vụ RAG chi phí thấp?
Nếu hệ thống xử lý lượng lớn dữ liệu phi cấu trúc như video, âm thanh và file PDF quét (Scan PDF) có dung lượng hàng chục MB, Gemini 3.8 Flash vượt trội nhờ khả năng tiếp nhận ngữ cảnh 4 triệu token và xử lý đa thể thức tự nhiên. Nếu dữ liệu thuần văn bản và cần bảo mật On-premise, DeepSeek 4.1 là phương án tối ưu hơn về mặt tự chủ kiểm soát chi phí lâu dài.
GPT-6 Astra có hoàn toàn thay thế được lập trình viên con người trên DeepSWE không?
Mặc dù GPT-6 Astra đạt kết quả ấn tượng trên benchmark DeepSWE, mô hình vẫn đóng vai trò là một trợ lý ảo siêu cấp (Copilot) thay vì thay thế hoàn toàn con người. AI vẫn cần các kỹ sư cao cấp thiết lập phạm vi bài toán, kiểm tra các giả định logic kinh doanh chuyên thù và giám sát phê duyệt các commit quan trọng vào môi trường Production.
Lời Kết
Bảng tổng kết hành động cụ thể để triển khai hiệu quả hệ sinh thái GPT-6 Astra, Deepseek 4.1, Gemini 3.8 Flash, Fable 5.1, Qwen3.8 trong hạ tầng phần mềm:
- Bước 1: Kiểm toán dữ liệu và phân loại tác vụ: Rà soát toàn bộ prompt trong hệ thống, phân chia rõ ràng giữa tác vụ cần phản hồi tức thì và tác vụ suy luận phân tích sâu.
- Bước 2: Xây dựng Router Gateway: Triển khai bộ định tuyến thông minh để phân luồng tự động giữa Gemini 3.8 Flash (tác vụ nhẹ, tốc độ cao) và Claude Fable 5.1 hoặc GPT-6 Astra (tác vụ logic cao cấp).
- Bước 3: Tận dụng Semantic Cache: Thiết lập bộ nhớ đệm ngữ nghĩa trên Vector DB để giảm thiểu ít nhất 30% lượng token trùng lặp gửi đến các nhà cung cấp API.
- Bước 4: Đánh giá khả năng tự host: Lập kế hoạch chi phí kiểm thử DeepSeek 4.1 hoặc Qwen 3.8 trên cụm máy chủ nội bộ nếu lưu lượng thực tế vượt ngưỡng 100 triệu token/ngày.
Bình luận