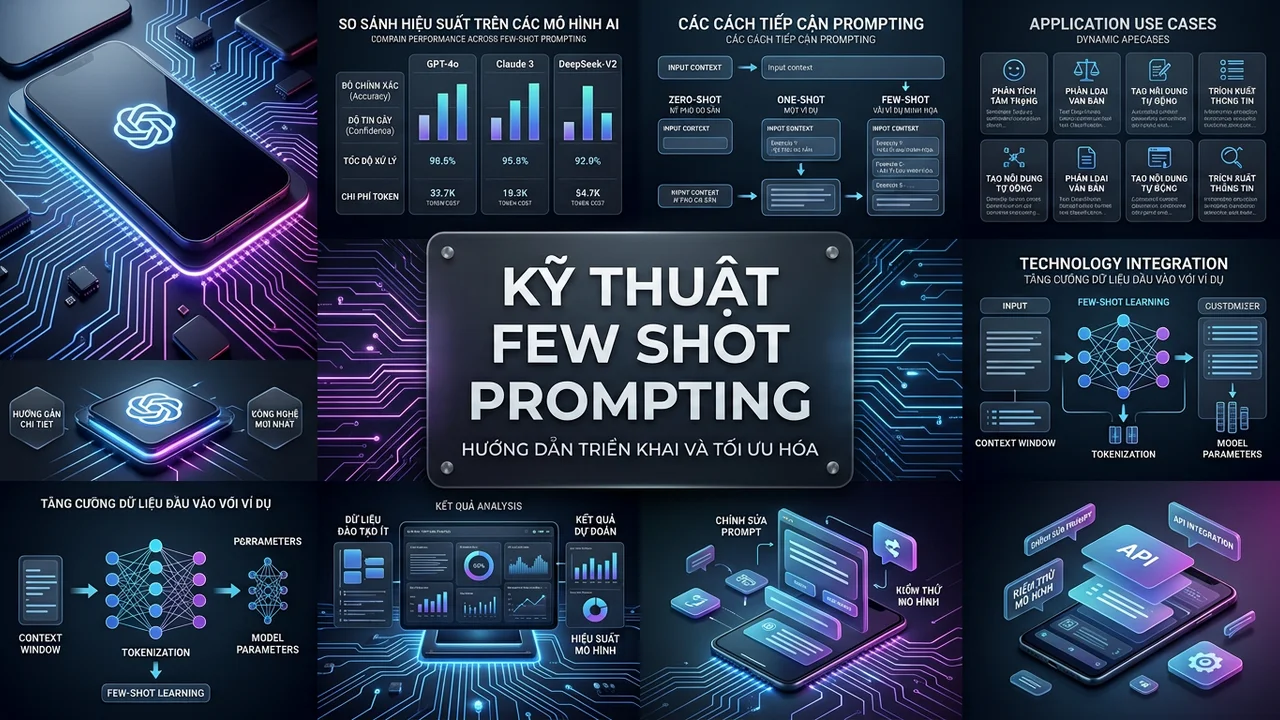
Xác định chính xác few shot prompting là gì là bước khởi đầu bắt buộc để giải quyết bài toán suy luận thiếu ổn định và lỗi định dạng đầu ra trên các mô hình ngôn ngữ lớn (LLM).
Khi xử lý các tác vụ phức tạp như trích xuất dữ liệu JSON hay phân loại đa tầng, phương pháp Zero-shot thuần túy thường dẫn đến tỷ lệ lỗi phân tích cú pháp (parse error) lên tới 18% do mô hình không nắm bắt được kỳ vọng cụ thể của hệ thống.
Hiểu rõ kỹ thuật few shot prompting là gì cho phép các kỹ sư Prompt Engineering kích hoạt năng lực học theo ngữ cảnh (In-Context Learning), giúp mô hình phỏng đoán quy luật thông qua một số mẫu đại diện mà không cần can thiệp vào trọng số mạng nơ-ron. Bạn có thể tham khảo thêm các mẫu cấu trúc chuyên sâu tại thư viện prompt AI được chuẩn hóa cho môi trường doanh nghiệp.
Bản chất cơ chế In-Context Learning trong kiến trúc Transformer
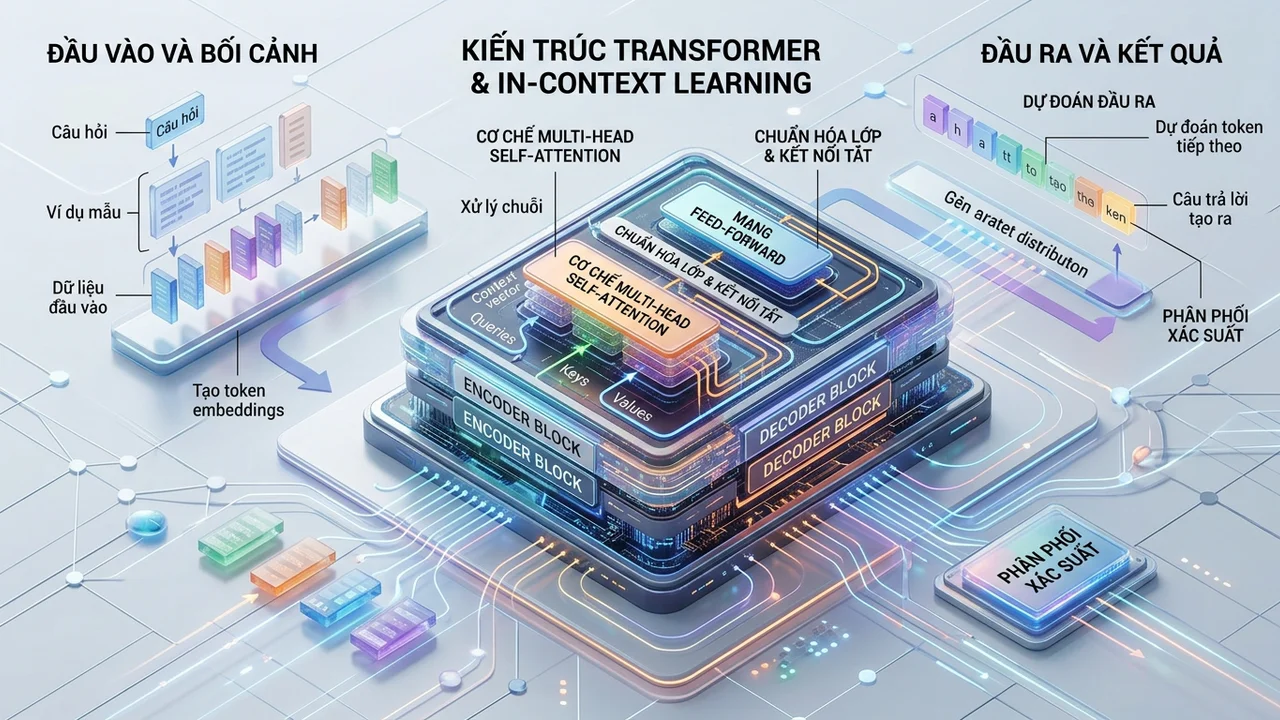
Khi nghiên cứu chuyên sâu few shot prompting là gì trong cấu trúc Transformer, điểm mấu chốt nằm ở cơ chế Attention (Cơ chế chú ý). Kỹ thuật này hoạt động dựa trên nguyên lý In-Context Learning (ICL): mô hình quan sát mối quan hệ giữa các cặp đầu vào (Input) và đầu ra (Output) mẫu được cung cấp ngay trong ngữ cảnh tạm thời của phiên truy vấn.
Bản chất kỹ thuật của few shot prompting là gì hoàn toàn khác biệt với quá trình huấn luyện truyền thống. Trọng số (weights) của mô hình giữ nguyên trạng thái đóng băng; thay vào đó, các vector ẩn (hidden states) bên trong các lớp Self-Attention sẽ tự động căn chỉnh và tập trung vào các token đại diện để nội suy ra khuôn mẫu xử lý logic cho câu hỏi đích tiếp theo.
Để hiểu sâu few shot prompting là gì ở góc độ tối ưu hóa hạ tầng năm 2026, cần chú ý đến công nghệ Prompt Caching. Trước đây, việc lặp lại các ví dụ mẫu trong prompt làm tăng chi phí token đầu vào.
Hiện nay, các nền tảng như OpenAI API, Anthropic Claude và Google Gemini đều cung cấp bộ đệm KV-Cache, giúp giảm từ 50% đến 90% chi phí xử lý và hạ thấp tới 80% thời gian tạo token đầu tiên (Time To First Token - TTFT) cho các mẫu Few-shot cố định.
Cấu trúc một bộ dữ liệu mẫu Few-shot đạt chuẩn
Khái niệm cấu trúc trong few shot prompting là gì? Đó là việc phân định rõ ràng ranh giới giữa chỉ dẫn hệ thống, các cặp ví dụ minh họa và dữ liệu truy vấn thực tế. Một cấu trúc chuẩn hóa giúp loại bỏ hiện tượng ảo giác (hallucination) và đảm bảo tính nhất quán tuyệt đối của phản hồi.
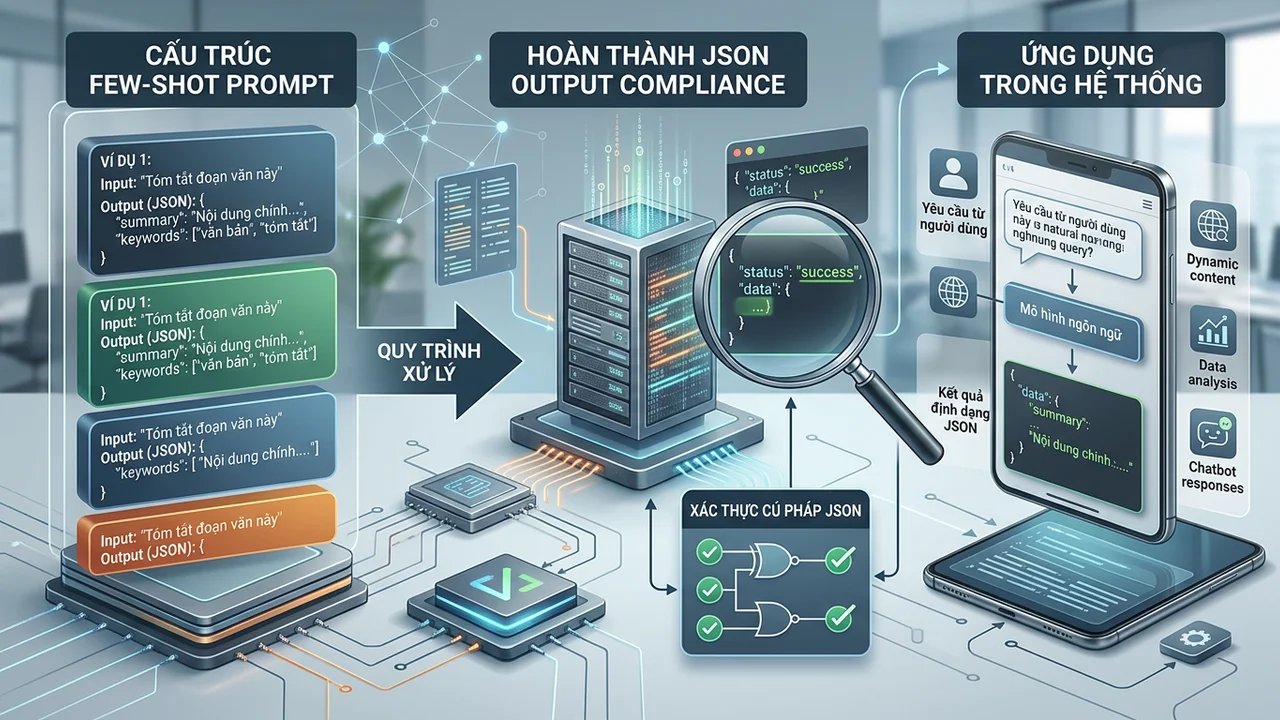
Trong triển khai công nghiệp, tiêu chuẩn cấu hình cho few shot prompting là gì thường bao gồm ba phần cố định: phần mô tả vai trò (System Directive), từ 3 đến 5 khối ví dụ đối ứng đồng nhất (Input/Output Pairs) và phần kết thúc mở dành cho dữ liệu cần xử lý. Ví dụ minh họa:
[CHỈ DẪN HỆ THỐNG]: Phân loại phản hồi khách hàng và xuất định dạng JSON. ### VÍ DỤ 1 Đầu vào: "Giao diện ứng dụng tải rất chậm khi chuyển trang." Đầu ra: {"intent": "bug_report", "sentiment": "negative", "urgency": "high"} ### VÍ DỤ 2 Đầu vào: "Tính năng xuất file CSV hoạt động rất mượt mà." Đầu ra: {"intent": "praise", "sentiment": "positive", "urgency": "low"} ### THỰC THI Đầu vào: "Tôi không thể cập nhật thông tin thẻ thanh toán." Đầu ra:Lợi ích lớn nhất khi hiểu rõ few shot prompting là gì trong chuẩn hóa định dạng là khả năng ghìm chặt cấu trúc trả về. Thử nghiệm trên mô hình GPT-4o cho thấy, việc đưa 3 ví dụ mẫu chuẩn JSON giúp kéo giảm tỷ lệ Parse Error từ 18% xuống dưới 0.8%, loại bỏ hoàn toàn các ký tự dẫn chuyện không cần thiết.
Kỹ thuật chọn lọc và đa dạng hóa ví dụ để tránh hiện tượng Recency Bias
Xử lý độ nhiễu và sai lệch khi ứng dụng few shot prompting là gì đòi hỏi kỹ sư phải nắm rõ các thiên kiến nhận thức nội tại của LLM, tiêu biểu là Recency Bias (Thiên vị vị trí gần) và Label Bias (Thiên vị nhãn xuất hiện nhiều).
Hiện tượng thiên vị nhãn trong few shot prompting là gì? Đó là tình trạng mô hình có xu hướng bắt chước nhãn của ví dụ nằm ở vị trí cuối cùng trong danh sách hoặc nhãn chiếm số lượng áp đảo.
Để vô hiệu hóa sai lệch này, các bộ dữ liệu mẫu cần tuân thủ nghiêm ngặt nguyên tắc cân bằng nhãn: nếu phân loại 3 trạng thái (Tích cực - Tiêu cực - Trung tính), số lượng mẫu cho mỗi nhãn phải tương đương nhau và được xáo trộn ngẫu nhiên.
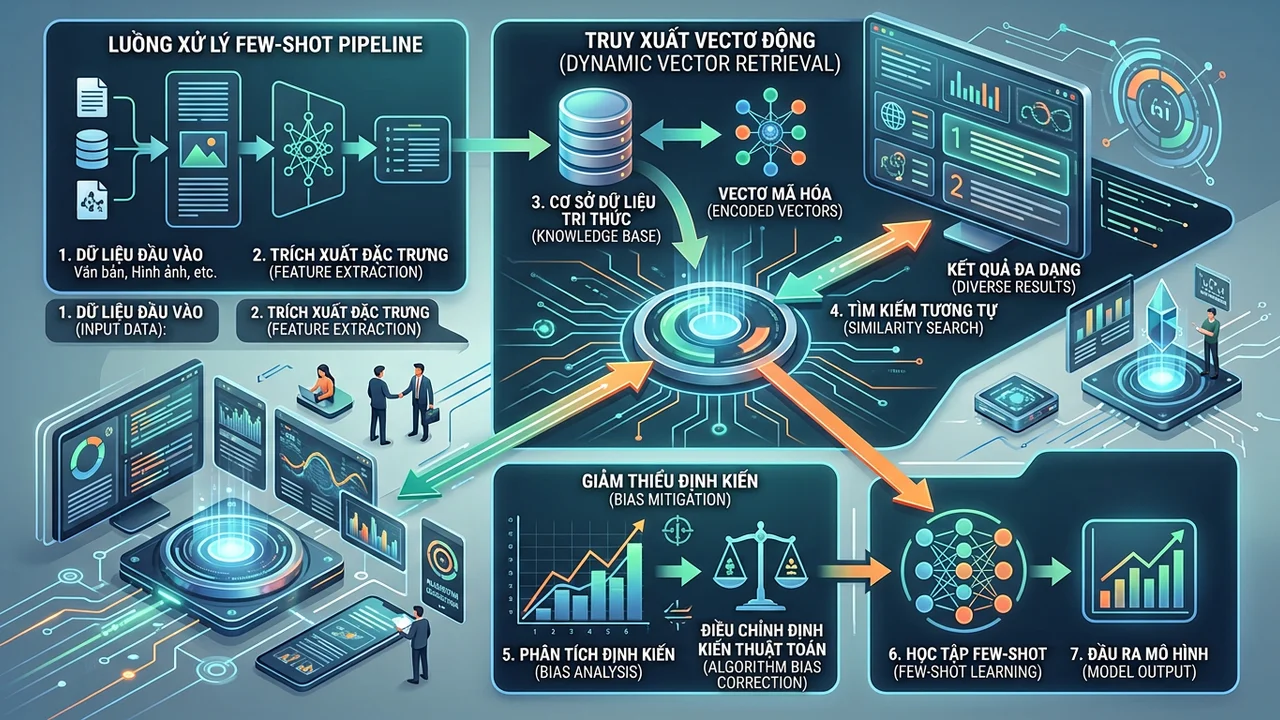
Bên cạnh đó, việc áp dụng Dynamic Retrieval mở rộng khả năng của few shot prompting là gì lên một tầm cao mới. Thay vì nhúng các ví dụ tĩnh vào prompt, hệ thống sẽ kết nối với Vector Database (như Qdrant, Pinecone hoặc Chroma).
Khi có truy vấn từ người dùng, thuật toán k-Nearest Neighbors (k-NN) tìm kiếm các mẫu tương đồng nhất về mặt ngữ nghĩa trong kho dữ liệu để đưa vào ngữ cảnh, gia tăng độ chính xác phân loại thêm từ 6% đến 12% so với Static Few-shot.
Bài toán thực nghiệm: Phân loại sắc thái cảm xúc và gán nhãn dữ liệu kỹ thuật
Bài toán thực nghiệm kiểm chứng few shot prompting là gì trên tập dữ liệu gán nhãn kỹ thuật phức tạp đã chứng minh ưu thế vượt trội của phương pháp này. Khi phân loại log lỗi máy chủ chứa nhiều thuật ngữ đan xen, Zero-shot thường gán nhãn sai lệch do không nhận diện được ngữ cảnh cục bộ của hệ thống.
Ứng dụng phân tích thực tế chứng minh vai trò của few shot prompting là gì: cung cấp các tình huống biên (edge cases) mà mô hình nền tảng chưa từng tiếp cận sâu. Khi bổ sung 4 ví dụ phân biệt giữa lỗi phần cứng và xung đột thư viện phần mềm, độ chính xác F1-Score trên các mô hình Claude 3.5 Sonnet và GPT-4o tăng từ 0.71 lên 0.94.
Quy tắc 3-5 Shot thực chiến: Đối với hơn 80% tác vụ xử lý ngôn ngữ tự nhiên thông thường, việc cung cấp từ 3 đến 5 ví dụ là ngưỡng tối ưu. Việc nâng số lượng ví dụ lên trên 10 shot thường chỉ mang lại mức tăng hiệu năng dưới 1% nhưng lại tiêu tốn tài nguyên ngữ cảnh không cần thiết.
Thực tế kiểm tra khả năng suy luận logic trên benchmark GSM8K cho thấy, kết hợp Chain-of-Thought (CoT) vào few shot prompting là gì sẽ thúc đẩy mô hình giải thích từng bước trung gian trong ví dụ mẫu, đưa tỷ lệ giải toán chính xác từ mức dưới 40% lên trên 90%.
So sánh hiệu quả chi phí token giữa Few-shot và Tinh chỉnh mô hình (Fine-tuning)
Phân tích tài chính giải thích few shot prompting là gì và vị trí của nó trong chiến lược đầu tư công nghệ của doanh nghiệp là yếu tố then chốt trước khi phê duyệt ngân sách triển khai AI.
So sánh với Fine-tuning giúp làm rõ ranh giới kỹ thuật của few shot prompting là gì. Fine-tuning yêu cầu chi phí hạ tầng GPU lớn, tập dữ liệu sạch gồm hàng nghìn bản ghi và quy trình kiểm thử phức tạp. Ngược lại, Few-shot Prompting có chi phí thiết lập ban đầu gần như bằng 0 và cho phép sửa đổi quy tắc nghiệp vụ chỉ sau vài giây cập nhật prompt.
| Tiêu chí đánh giá | Zero-Shot Prompting | Few-Shot Prompting | Fine-Tuning (LoRA / Full FT) |
|---|---|---|---|
| Bản chất kỹ thuật | Chỉ thị thuần túy, không có dữ liệu mẫu. | Chỉ thị kèm 2-5 ví dụ mẫu trong ngữ cảnh (ICL). | Cập nhật trực tiếp trọng số mạng nơ-ron mô hình. |
| Độ phức tạp thiết lập | Cực kỳ đơn giản. | Thấp đến Trung bình (tuyển chọn mẫu chuẩn). | Rất cao (chuẩn bị dataset, pipeline huấn luyện). |
| Chi phí khởi tạo ban đầu | 0 USD. | Gần như 0 USD. | Vài trăm đến hàng nghìn USD chi phí compute GPU. |
| Chi phí vận hành token | Thấp nhất trên mỗi request. | Tăng phụ phí token ví dụ (tối ưu qua Prompt Caching). | Thấp (prompt ngắn gọn do tri thức đã nằm trong model). |
| Độ ổn định định dạng JSON | Kém, thường xuất hiện văn bản thừa. | Rất cao (>99% tuân thủ định dạng). | Tuyệt đối (được đóng băng vào hành vi mô hình). |
| Thời gian thay đổi logic | Tức thì. | Tức thì (chỉnh sửa text ví dụ). | Chậm (phải huấn luyện và triển khai lại model). |
Đánh giá chi phí vận hành của few shot prompting là gì: Với một bộ 5 ví dụ tiêu chuẩn tiêu tốn khoảng 400 token đầu vào, khi tích hợp cơ chế Prompt Caching, chi phí tăng thêm cho mỗi triệu lượt gọi API chỉ dao động từ vài cent đến dưới 0.5 USD trên các model tối ưu như GPT-4o-mini hay Gemini 2.0 Flash.
Để xây dựng các giải pháp tối ưu tổng thể, bạn đọc có thể tham khảo thêm tại cổng thông tin công nghệ thanhtuan.vn.
Câu hỏi thường gặp (FAQ)
Sự khác biệt cốt lõi của few shot prompting là gì so với zero-shot?
Zero-shot yêu cầu mô hình giải quyết tác vụ chỉ bằng lời mô tả mà không có dữ liệu đối chiếu. Ngược lại, điểm khác biệt của few shot prompting là gì nằm ở việc đưa trực tiếp các cặp ví dụ mẫu cụ thể để mô hình phỏng chiếu cấu trúc ngữ nghĩa và định dạng đầu ra trước khi thực thi.
Số lượng ví dụ tối ưu trong few shot prompting là gì?
Từ 3 đến 5 ví dụ là tiêu chuẩn vàng cho đại đa số tác vụ nghiệp vụ. Việc đưa quá nhiều ví dụ không chỉ làm tăng chi phí token mà còn có thể gây loãng sự chú ý của các Attention head, trừ khi hệ thống triển khai kiến trúc Many-Shot chuyên biệt với hàng trăm mẫu.
Hạn chế kỹ thuật lớn nhất của few shot prompting là gì?
Hạn chế lớn nhất là sự gia tăng độ trễ TTFT và chi phí token đầu vào trên mỗi request lặp lại nếu không bật cơ chế Prompt Caching. Đồng thời, kỹ thuật này nhạy cảm với thứ tự sắp xếp của các ví dụ (Recency Bias).
Lời kết và danh sách kiểm tra triển khai thực tế
Nắm bắt đầy đủ few shot prompting là gì tạo tiền đề vững chắc để chuẩn hóa dữ liệu đầu ra cho các hệ thống AI tự động hóa. Hãy áp dụng danh sách kiểm tra sau trước khi đưa prompt vào môi trường production:
- Đảm bảo đã cung cấp đủ từ 3 đến 5 ví dụ minh họa đại diện cho toàn bộ các nhãn phân loại.
- Phân bổ cân bằng vị trí của các nhãn trong danh sách ví dụ để vô hiệu hóa Recency Bias.
- Khóa chặt định dạng đầu ra mong muốn (JSON/XML) đồng nhất trong toàn bộ các khối Output mẫu.
- Kích hoạt cơ chế Prompt Caching tại các tầng API trung gian để tiết kiệm chi phí token vận hành.
- Ưu tiên thử nghiệm Dynamic Retrieval Few-shot trước khi cân nhắc phương án Fine-tuning tốn kém.
Bình luận