Phân Biệt Zero-Shot, Few-Shot và Many-Shot Prompting: Hướng dẫn few-shot prompting
 Tuấn Lê
Tỷ lệ lỗi trích xuất định dạng JSON và suy luận sai lệch trong các hệ thống tích hợp mô hình ngôn ngữ lớn (LLM) thường dao động từ 15% đến 30% nếu chỉ phụ thuộc vào câu lệnh đơn lẻ.
Áp dụng kỹ thuật few-shot prompting là giải pháp tiêu chuẩn kỹ thuật hàng đầu hiện nay giúp lập trình viên kiểm soát tính nhất quán của kết quả trả về, định hình cấu trúc dữ liệu khắt khe mà không cần can thiệp tái huấn luyện trọng số mô hình.
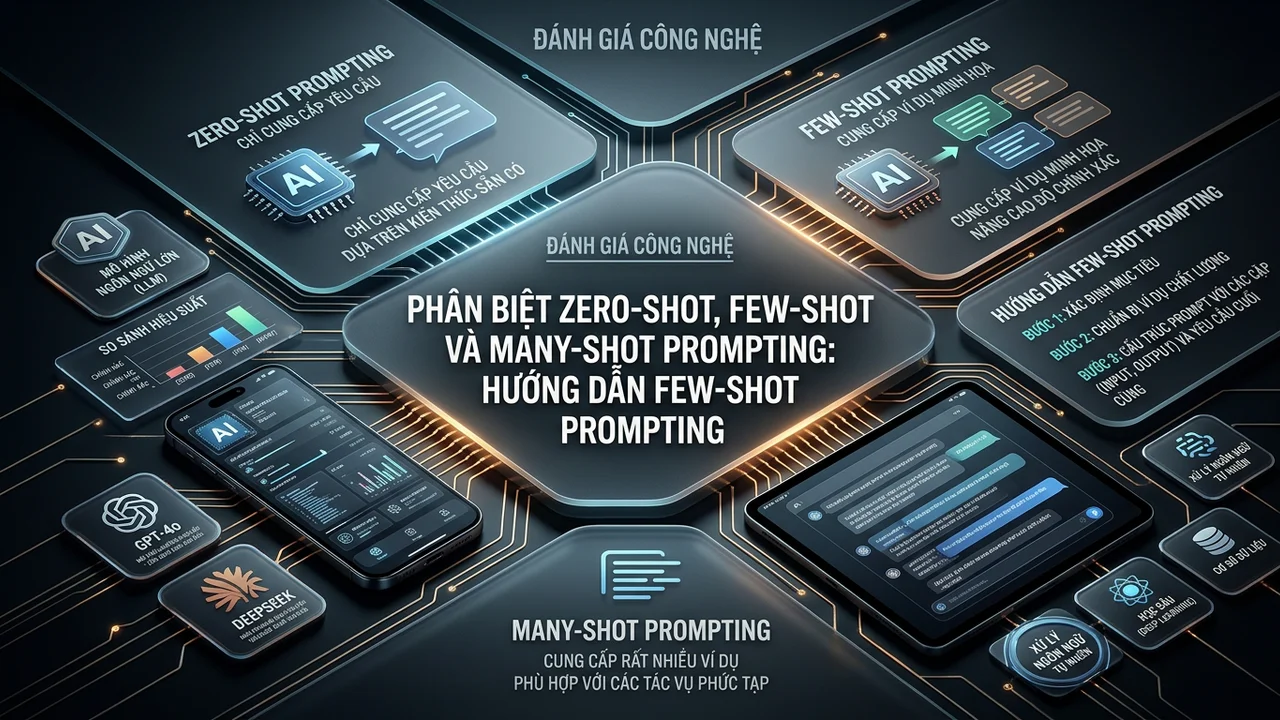
Trong khi Zero-shot prompting yêu cầu AI giải quyết bài toán chỉ bằng chỉ dẫn thuần túy, few-shot prompting cung cấp một tập hợp nhỏ các cặp mẫu Đầu vào - Đầu ra (Input - Output pairs) đóng vai trò làm điểm tựa ngữ cảnh trực tiếp.
Sự phát triển vượt bậc của các mô hình như Claude 3.5 Sonnet, Claude 3.7 Sonnet, GPT-4o, DeepSeek V3 và Gemini 2.0 Flash đã đưa kỹ thuật few-shot prompting trở thành nền tảng cốt lõi trong quy trình kỹ thuật prompt cấp doanh nghiệp.
Cân nhắc giữa Zero-shot và Few-shot trong triển khai thực tế
Việc lựa chọn giữa Zero-shot và few-shot prompting không chỉ đơn thuần là việc thêm hay bớt vài dòng ví dụ trong câu lệnh. Đây là quyết định kiến trúc ảnh hưởng trực tiếp đến chi phí tài nguyên, độ trễ hệ thống và tính ổn định của pipeline AI.
Kịch bản tối ưu cho Zero-Shot và ranh giới chuyển đổi
Zero-shot prompting phát huy hiệu quả cao nhất ở các tác vụ mang tính sáng tạo mở, tóm tắt nội dung khái quát hoặc các cuộc hội thoại ngôn ngữ thông thường.
Khi yêu cầu của tác vụ không ràng buộc một khuôn mẫu cú pháp nghiêm ngặt và tri thức nền tảng của mô hình đã đủ dày, Zero-shot giúp tiết kiệm tối đa số lượng token đầu vào, giữ độ trễ phản hồi ban đầu (Time-to-First-Token - TTFT) ở mức thấp nhất.
Tuy nhiên, ranh giới thất bại của Zero-shot xuất hiện ngay khi hệ thống đòi hỏi trích xuất thực thể theo lược đồ cơ sở dữ liệu tùy biến, phân loại cảm xúc chuyên ngành có nhãn biên mỏng hoặc xử lý dữ liệu đầu vào chứa nhiều trường hợp ngoại lệ.
Trong các trường hợp này, việc tiếp tục cố gắng mô tả dài dòng bằng ngôn ngữ tự nhiên chỉ làm tăng độ ảo giác (hallucination) của mô hình thay vì nâng cao chất lượng kết quả.
Tầm quan trọng sống còn của Few-Shot trong Pipeline sản xuất
Khi đưa mô hình vào môi trường vận hành thực tế (Production), kỹ thuật few-shot prompting chuyển hóa các hướng dẫn mơ hồ thành hành vi trực quan mà mô hình có thể mô phỏng chính xác. Bằng cách quan sát từ 2 đến 5 ví dụ minh họa, mô hình nhanh chóng nhận diện khuôn mẫu cú pháp, định dạng kiểu dữ liệu và sắc thái diễn đạt đặc thù của domain doanh nghiệp.
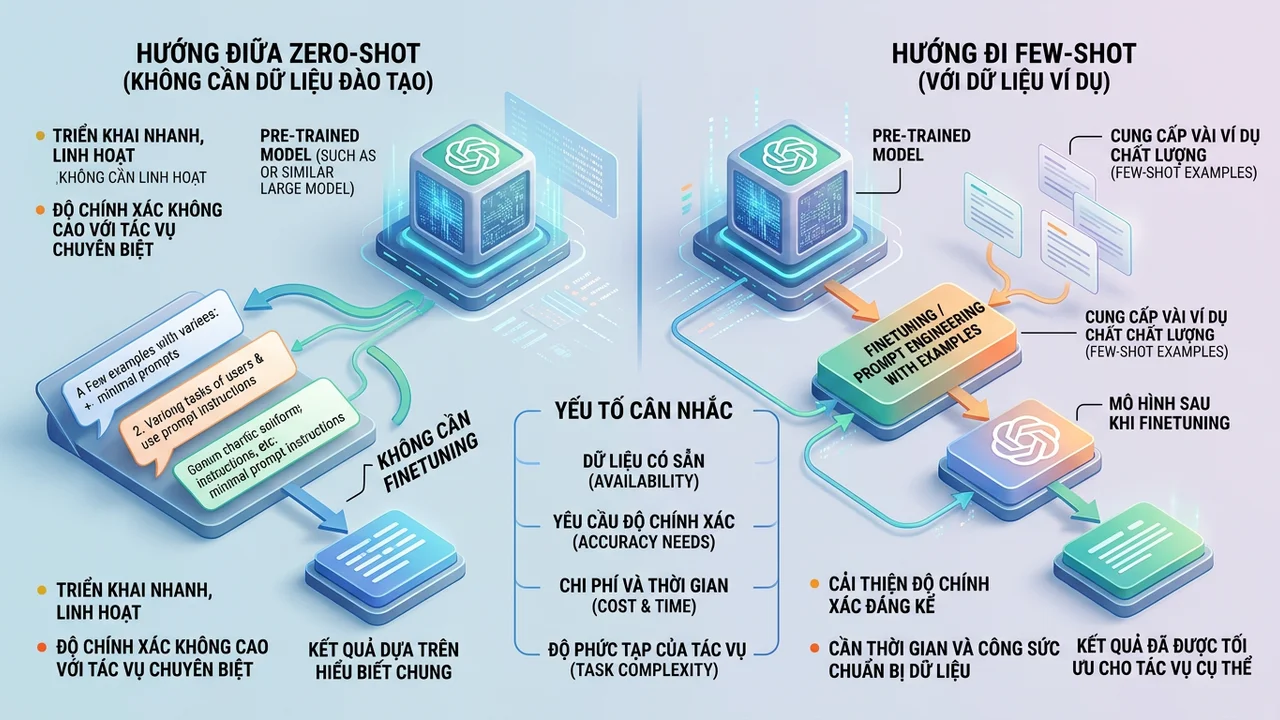
Đặc biệt đối với các tác vụ phân tích ngôn ngữ pháp lý, tài chính hoặc y khoa, few-shot prompting đóng vai trò như một bộ quy tắc mẫu định hình tư duy của mô hình. Tỷ lệ tuân thủ lược đồ JSON hoặc định dạng Regex tăng vọt từ mức 75% lên trên 98% khi hệ thống được cấp các ví dụ mẫu chuẩn mực thông qua few-shot prompting.
Cấu trúc bộ dữ liệu mẫu (Input-Output pairs) chuẩn mực
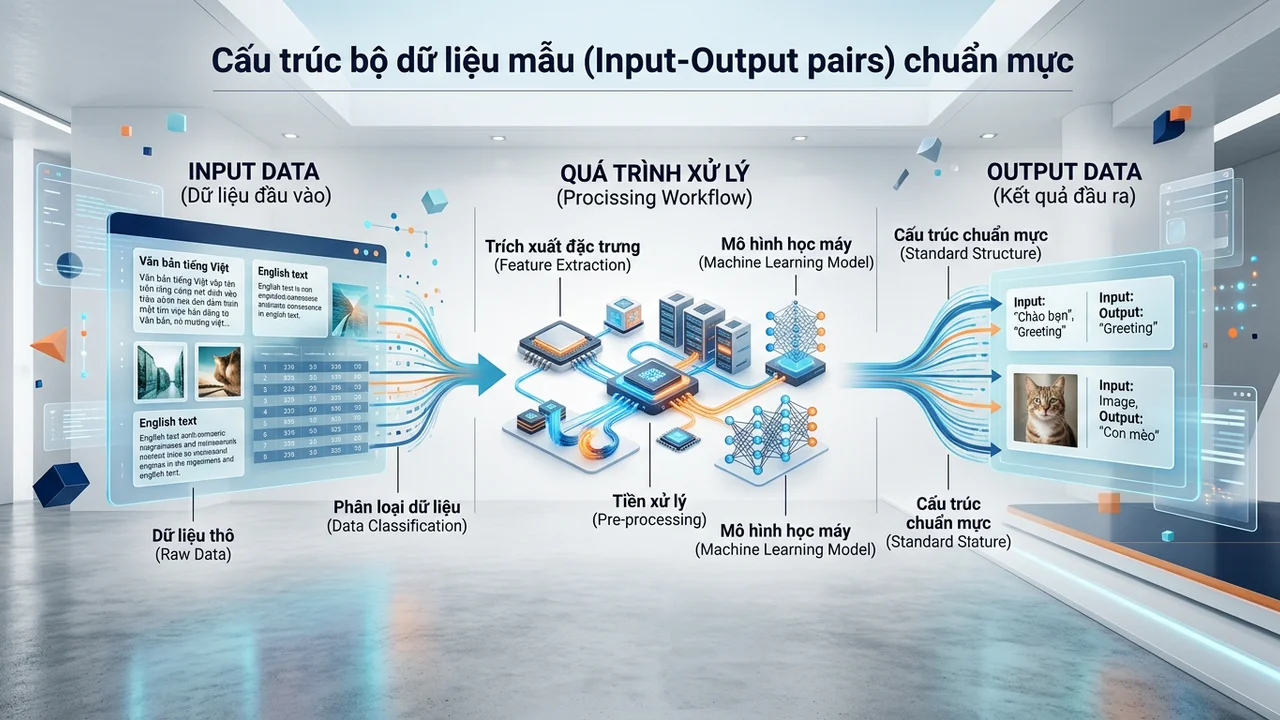
Chất lượng của một chuỗi few-shot prompting phụ thuộc hoàn toàn vào cách thiết kế và đóng gói các cặp Input - Output. Một cấu trúc cẩu thả hoặc mâu thuẫn sẽ khiến mô hình sao chép lại chính các lỗi sai đó trong câu trả lời tiếp theo.
Thiết lập thẻ định danh và phân cách tường minh
Mô hình ngôn ngữ hoạt động theo nguyên lý dự đoán token tiếp theo dựa trên xác suất chuỗi. Do đó, việc sử dụng các thẻ phân cách tường minh (Explicit Delimiters) như cú pháp XML hoặc Markdown là bắt buộc để LLM phân biệt ranh giới giữa phần chỉ dẫn hệ thống, các ví dụ mẫu và truy vấn thực tế của người dùng.
Một mẫu cấu trúc chuẩn mực cho few-shot prompting doanh nghiệp thường bao gồm các khối thẻ phân tầng rõ ràng:
<system_instruction>
Nhiệm vụ: Trích xuất thực thể tên công ty và số tiền đầu tư từ văn bản tin tức sang định dạng JSON.
</system_instruction>

<examples>
  <example id="1">
    <input>Startup Alpha vừa hoàn tất vòng gọi vốn Hạt giống trị giá 2.5 triệu USD từ quỹ đầu tư mạo hiểm Beta.</input>
    <output>{"company": "Startup Alpha", "amount": 2500000, "currency": "USD", "round": "Seed"}</output>
  </example>
  <example id="2">
    <input>Tập đoàn X công bố thoái vốn khỏi công ty con nhưng không tiết lộ giá trị thương vụ cụ thể.</input>
    <output>{"company": "Tập đoàn X", "amount": null, "currency": null, "round": "Unknown"}</output>
  </example>
</examples>

<query>
  <input>Công ty Gama tiếp nhận khoản tài trợ phát triển 500 nghìn Euro trong sáng nay.</input>
  <output>
Tích hợp chuỗi suy luận (Few-Shot Chain-of-Thought)
Đối với các bài toán đòi hỏi tính toán logic, suy luận logic nhiều bước hoặc xử lý dữ liệu phi cấu trúc phức tạp, việc chỉ cung cấp kết quả đầu ra cuối cùng trong few-shot prompting là chưa đủ. Mô hình rất dễ đưa ra đáp án sai lệch do bước nhảy tư duy quá lớn.
Giải pháp tối ưu là tích hợp chuỗi suy luận Few-Shot Chain-of-Thought (Few-Shot CoT). Trong mỗi ví dụ mẫu, lập trình viên chèn thêm trường tư duy (Thought Process) giải thích từng bước biến đổi từ dữ liệu thô sang kết quả cuối cùng.
Kỹ thuật few-shot prompting kết hợp CoT kích hoạt khả năng suy luận logic sâu của các dòng mô hình tiên tiến như DeepSeek R1, GPT-4o hay Claude 3.7 Sonnet, gia tăng độ chuẩn xác vượt bậc trên các tập dữ liệu GSM8K và MATH.
Tác động của số lượng ví dụ mẫu đến giới hạn Token và độ trễ
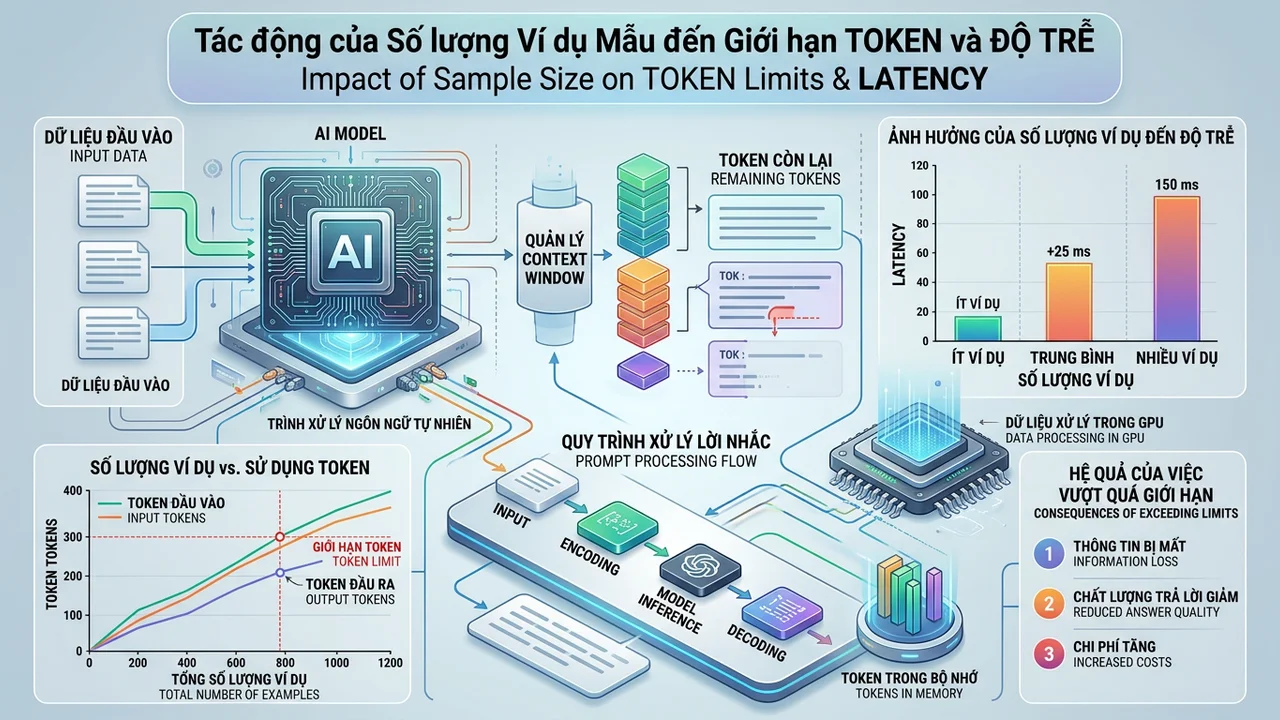
Mặc dù việc bổ sung nhiều ví dụ mẫu giúp định hình hành vi mô hình sắc nét hơn, nó lại tạo ra thách thức lớn về chi phí tính toán và độ trễ mạng nếu không có chiến lược kiểm soát cẩn trọng.
Nghẽn cổ chai TTFT và giải pháp Context Caching
Khi số lượng ví dụ trong few-shot prompting tăng lên, lượng token đầu vào (Input Tokens) gửi lên API của mỗi lượt gọi sẽ phình to. Điều này làm gia tăng đáng kể thời gian xử lý ban đầu (Time-to-First-Token - TTFT), gây hiện tượng nghẽn phản hồi đối với các ứng dụng yêu cầu tương tác thời gian thực.
Để giải quyết bài toán này, các nhà cung cấp nền tảng AI như Anthropic, OpenAI và Google đã triển khai công nghệ Context Caching (Bộ nhớ đệm ngữ cảnh).
Khi tập ví dụ few-shot prompting được đặt cố định ở đầu System Prompt và không thay đổi giữa các phiên gọi, hệ thống sẽ lưu trữ trạng thái KV-Cache trên cụm máy chủ xử lý. Cơ chế này giúp giảm độ trễ TTFT từ 70% đến 85% và hạ giá thành token đọc bộ nhớ đệm (Cache Read) từ 50% đến 90%.
Đây là kỹ thuật cốt lõi trong việc tối ưu token chatgpt và giảm chi phí hạ tầng quy mô lớn.
Bước chuyển dịch từ Few-Shot sang Many-Shot In-Context Learning
Với sự ra đời của các kiến trúc cửa sổ ngữ cảnh khổng lồ từ 1.000.000 đến 2.000.000 tokens trên các mô hình như Gemini 1.5/2.0 Pro hay Claude 3.5 Sonnet, ranh giới truyền thống của few-shot prompting (vốn chỉ giới hạn từ 3 đến 10 ví dụ) đã mở rộng thành Many-Shot In-Context Learning (ICL).
Nghiên cứu từ Anthropic và Google DeepMind chỉ ra rằng hiệu năng của mô hình tuân theo quy luật lũy thừa (Power Law) khi quy mô ví dụ nâng từ 5 mẫu (Few-shot) lên hàng trăm mẫu (Many-shot). Kỹ thuật Many-Shot ICL cho phép đưa toàn bộ cơ sở mã nguồn, cuốn từ điển chuyên ngành hoặc tài liệu pháp lý phức tạp vào làm mẫu mồi mà không cần thực hiện Supervised Fine-Tuning (SFT) phức tạp.
Chiến lược phân bổ mẫu để tránh thiên lệch thuật toán (Bias)
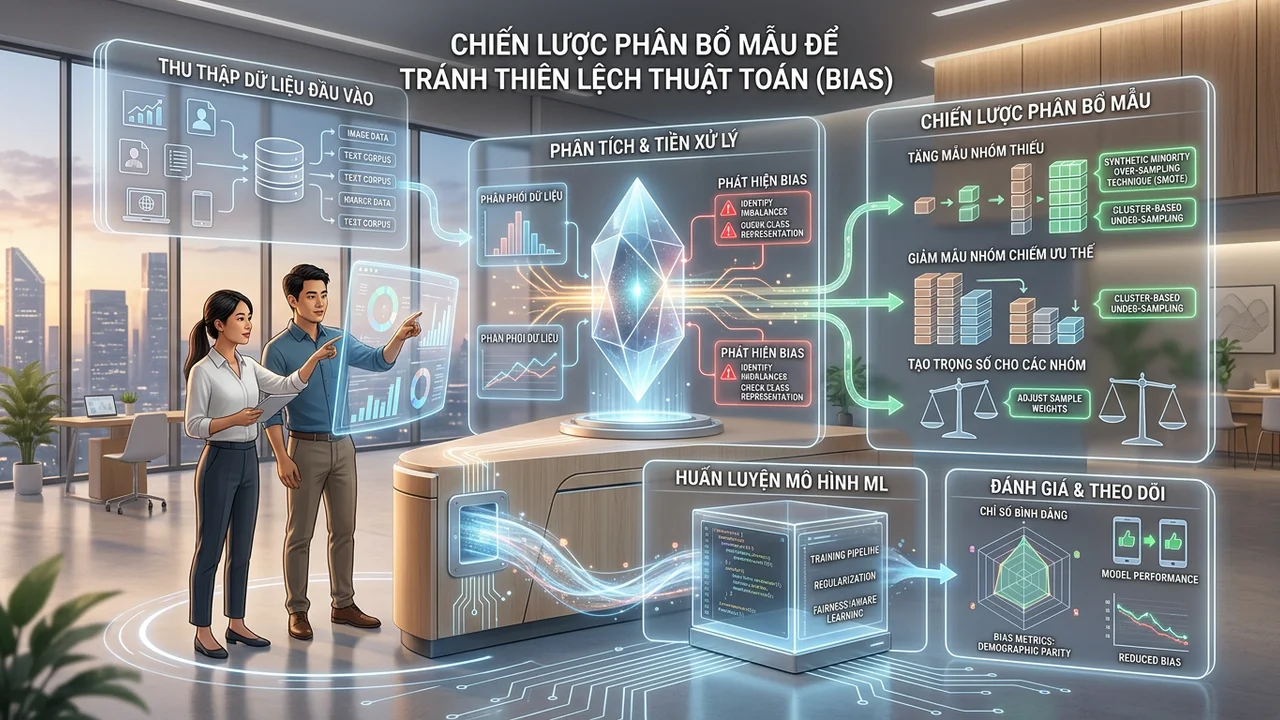
Một cạm bẫy kỹ thuật phổ biến khi ứng dụng few-shot prompting là vô tình tạo ra các dạng thiên lệch (Bias) khiến mô hình đưa ra phán đoán sai lầm mang tính hệ thống.
Kiểm soát Majority Label Bias và Recency Bias
Mô hình ngôn ngữ có xu hướng nhạy cảm cực cao với thứ tự và tỷ lệ xuất hiện của các nhãn trong tập ví dụ. Hai hiện tượng thiên lệch phổ biến nhất bao gồm:
- Majority Label Bias (Thiên lệch nhãn chiếm đa số): Nếu trong bộ 5 ví dụ few-shot prompting có đến 4 ví dụ thuộc nhãn "Tích cực" và chỉ 1 ví dụ nhãn "Tiêu cực", mô hình sẽ có xu hướng dự đoán nhãn "Tích cực" cho hầu hết các truy vấn mơ hồ kế tiếp.
- Recency Bias (Thiên lệch vị trí cận kề): Mô hình có xu hướng thiên vị nhãn hoặc phong cách định dạng của ví dụ cuối cùng nằm sát câu hỏi của người dùng nhất.
Để triệt tiêu các thiên lệch này, tập dữ liệu mẫu trong few-shot prompting phải được cân bằng tỷ lệ nhãn hoàn hảo (Balanced Distribution). Đồng thời, thứ tự các mẫu cần được xáo trộn ngẫu nhiên hoặc kiểm định đa phiên để tránh tạo ra mẫu hình quán tính giả tạo cho bộ suy luận.
Kỹ thuật Dynamic Retrieval Few-Shot qua Vector Database
Thay vì sử dụng một danh sách ví dụ tĩnh cho mọi trường hợp, các kiến trúc GenAI tiên tiến chuyển sang mô hình Dynamic Few-Shot Prompting kết hợp cơ sở dữ liệu véc-tơ (Vector Database). Khung lập trình prompt tự động như DSPy 3.1 từ Đại học Stanford với các module KNNFewShot hay MIPROv2 đang là chuẩn mực thực thi hàng đầu.
Quy trình triển khai Dynamic few-shot prompting diễn ra theo 4 bước khép kín:
- Hệ thống lưu trữ hàng nghìn cặp Input - Output đã được thẩm định chất lượng cao vào Vector DB dưới dạng các Vector Embeddings.
- Khi truy vấn của người dùng xuất hiện, hệ thống nhúng truy vấn và thực hiện tìm kiếm độ tương đồng Cosine hoặc k-Nearest Neighbors (kNN).
- Hệ thống tự động rút trích top 3 đến 5 ví dụ có ngữ cảnh tương đồng nhất với truy vấn cụ thể.
- Các ví dụ này được ghép động vào khuôn mẫu few-shot prompting và gửi đến LLM trong thời gian thực.
Bảng đối chiếu hiệu năng và chi phí của ba phương pháp
Để giúp các kỹ sư dữ liệu và kiến trúc sư hệ thống có cái nhìn toàn cảnh, bảng phân tích kỹ thuật dưới đây tổng hợp các thông số vận hành then chốt giữa Zero-Shot, Few-Shot và Many-Shot Prompting:
| Tiêu chí đánh giá | Zero-Shot Prompting | Few-Shot Prompting | Many-Shot Prompting |
|---|---|---|---|
| Quy mô số lượng ví dụ | 0 ví dụ (Chỉ dùng câu lệnh chỉ dẫn) | 2 – 10 ví dụ chọn lọc | 50 – 1.000+ ví dụ quy mô lớn |
| Độ chính xác định dạng (JSON, Regex) | 70% – 85% (Dễ phát sinh lỗi cú pháp) | 98% – 99.9% (Chuẩn mực doanh nghiệp) | Gần như tuyệt đối 100% |
| Khả năng ghi đè Pre-training Bias | Rất kém (Bị chi phối bởi dữ liệu gốc) | Trung bình (Định hướng tốt phong cách) | Rất mạnh (Tái định hình tư duy mô hình) |
| Mức tiêu thụ Token đầu vào | Thấp nhất (< 200 tokens) | Trung bình (500 – 2.500 tokens) | Cực cao (50.000 – 500.000+ tokens) |
| Độ trễ TTFT (Không có Cache) | Dưới 500ms | 500ms – 1.5 giây | 3 – 10+ giây |
| Hiệu quả tối ưu chi phí | Tốt nhất cho ứng dụng tra cứu đơn lẻ | Cân bằng tối ưu giữa chi phí và độ chuẩn | Bắt buộc kích hoạt Context Caching |
| Trường hợp ứng dụng thực tế | Brainstorm ý tưởng, viết nháp văn bản | Trích xuất dữ liệu, gắn nhãn chuyên ngành | Thay thế Supervised Fine-Tuning (SFT) |
Nhìn vào các chỉ số kỹ thuật, few-shot prompting thể hiện rõ vị thế là điểm cân bằng hoàn hảo (sweet spot) giữa chất lượng đầu ra và chi phí vận hành API đối với hầu hết các bài toán doanh nghiệp hiện hành.
Câu hỏi thường gặp (FAQ)
Bao nhiêu ví dụ là đủ cho một cấu hình few-shot prompting chuẩn?
Thông thường từ 3 đến 5 ví dụ là mức lý tưởng cho phần lớn các bài toán phân loại và định dạng dữ liệu có cấu trúc. Việc bổ sung trên 10 ví dụ mà không có Context Caching chỉ làm tăng chi phí và độ trễ mà không mang lại mức gia tăng đáng kể về độ chính xác.
Kỹ thuật few-shot prompting có thể thay thế hoàn toàn việc Fine-Tuning không?
Đối với các tác vụ trích xuất thông tin, tuân thủ định dạng và phân tích sắc thái ngữ nghĩa, few-shot prompting (hoặc Many-Shot ICL) hoàn toàn có thể thay thế Fine-Tuning mà vẫn đạt hiệu năng tương đương mà không tốn chi phí huấn luyện.
Tuy nhiên, nếu mục tiêu là nạp một khối lượng tri thức tĩnh khổng lồ hoặc tinh giản tối đa token đầu vào cho hàng triệu lượt gọi lặp đi lặp lại mỗi ngày, Fine-Tuning vẫn là lựa chọn chuyên biệt cần cân nhắc.
Khi nào nên dùng Dynamic Few-Shot thay cho Few-Shot tĩnh?
Dynamic few-shot prompting kết hợp Vector Search nên được ưu tiên khi miền dữ liệu quá rộng (hàng trăm loại hợp đồng, danh mục bệnh lý phức tạp) hoặc tập dữ liệu có phân phối phân tán cao. Khi đó, không một tập 5 ví dụ cố định nào có thể bao quát toàn bộ trường hợp đầu vào của người dùng.
Lời kết
Để triển khai thành công few-shot prompting trong hạ tầng sản xuất, các kỹ sư phần mềm cần chuyển đổi tư duy từ viết prompt cảm tính sang quy trình kỹ thuật định lượng. Việc kiểm soát từng token và thiết kế cấu trúc mẫu nhất quán sẽ quyết định sự thành bại của toàn bộ giải pháp AI.
Checklist hành động kiểm thử Few-Shot Prompting chuẩn sản xuất:
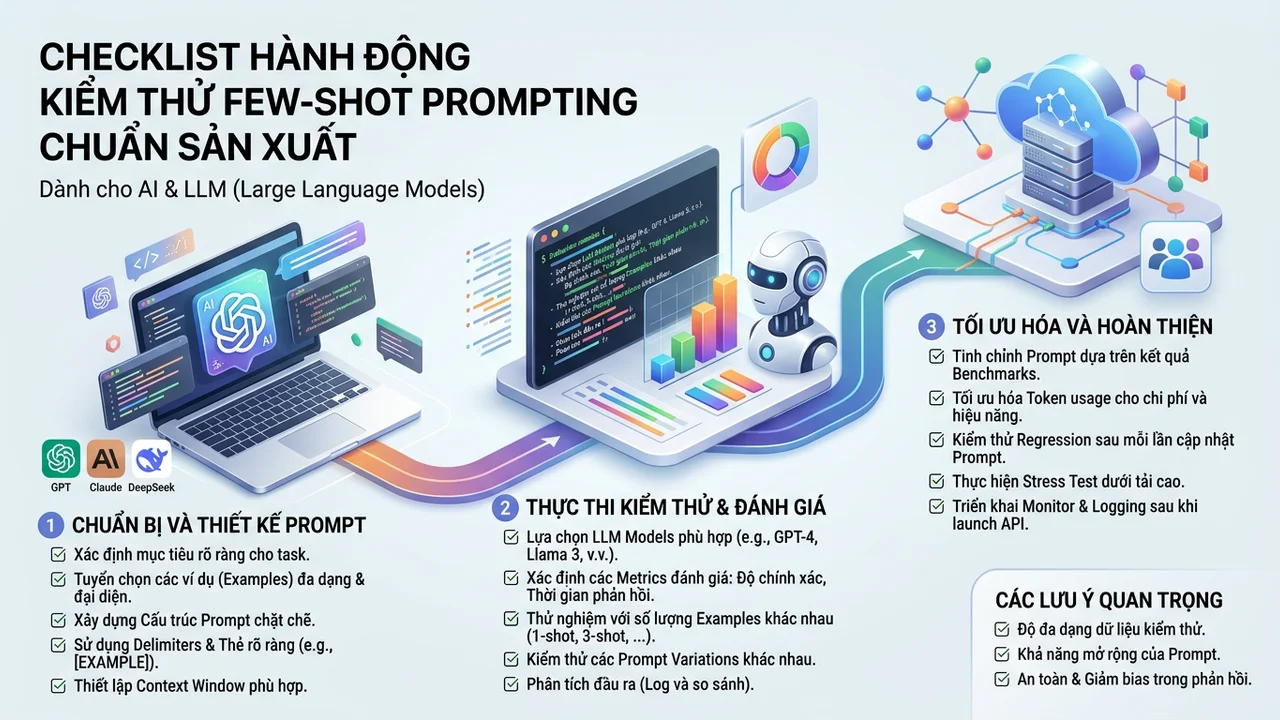
- Chuẩn hóa cấu trúc: Sử dụng thẻ XML hoặc Markdown phân định rõ ràng giữa chỉ dẫn, mẫu mồi và câu hỏi thực tế.
- Bao phủ trường hợp biên: Đảm bảo bộ mẫu có ít nhất 1 ví dụ chứa dữ liệu rỗng (null/empty) và 1 ví dụ định dạng số âm hoặc chuỗi bất thường.
- Cân bằng phân bổ nhãn: Triệt tiêu hoàn toàn Majority Label Bias bằng cách chia đều số lượng mẫu cho từng phân loại mục tiêu.
- Kích hoạt bộ đệm: Đặt khối mẫu few-shot prompting cố định ở phần đầu prompt để tối đa hóa tỷ lệ Cache Hit của Context Caching.
- Tự động hóa tuyển chọn: Tích hợp các bộ thư viện lập trình prompt như DSPy để tự động đánh giá và tối ưu hóa tập mẫu mồi dựa trên độ đo thực nghiệm.
Bình luận