chain of thought prompt - Kỹ Thuật Chain of Thought: Nâng Năng Lực Suy Luận Của AI
 Tuấn Lê
Khi giải quyết các bài toán logic phân tầng hay gỡ lỗi mã nguồn phức tạp, mô hình ngôn ngữ lớn thường tạo ra kết quả sai lệch nếu chỉ áp dụng câu lệnh trực tiếp thông thường.
Kỹ thuật chain of thought prompt (chuỗi suy luận từng bước) xuất hiện nhằm xử lý triệt để lỗ hổng này, buộc hệ thống AI phải phân rã vấn đề thành các mắt xích logic nhỏ trước khi đưa ra câu trả lời sau cùng.
Phương pháp này đã chuyển mình mạnh mẽ từ các câu lệnh gợi ý thủ công sang kiến trúc suy luận gốc (Native Reasoning). Việc nắm vững cấu trúc xây dựng chain of thought prompt giúp lập trình viên và kỹ sư tối ưu hóa độ chính xác của các mô hình hàng đầu hiện nay như DeepSeek-R1, OpenAI o3-mini hay Claude 3.7 Sonnet.
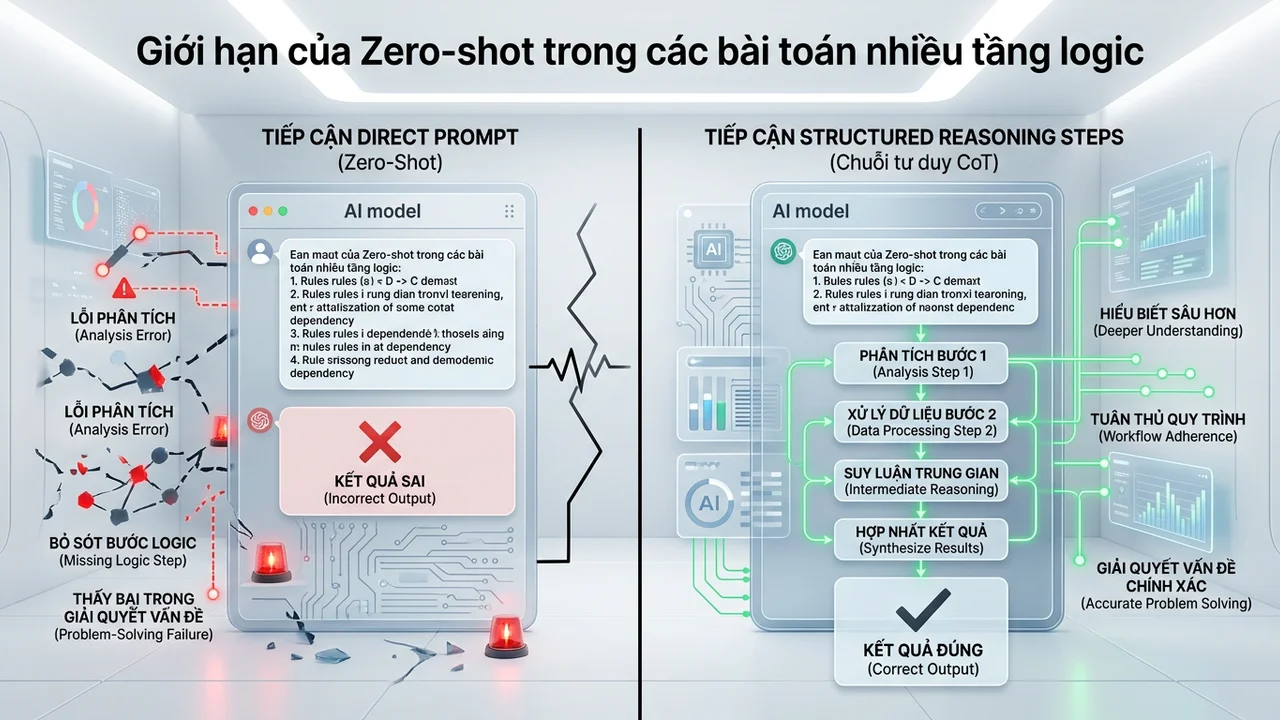
Giới hạn của Zero-shot trong các bài toán nhiều tầng logic và góc nhìn về chain of thought prompt
Phương pháp Zero-shot truyền thống yêu cầu mô hình phản hồi ngay lập tức sau câu hỏi đầu vào mà không qua bước đệm tư duy. Cách tiếp cận này hoạt động ổn định với các tác vụ trích xuất văn bản hoặc tóm tắt nội dung, nhưng bộc lộ sai số lớn khi xử lý các chuỗi logic đa tầng.
Hiện tượng ảo giác dây chuyền (cascading hallucination) xuất hiện khi mô hình phỏng đoán xác suất token tiếp theo một cách vội vã. Chỉ cần một biến số toán học bị tính sai ở bước đầu, toàn bộ kết luận phía sau sẽ sụp đổ, khiến câu lệnh trực tiếp không thể vượt qua các bài thi kiểm thử chuyên sâu như AIME hay GPQA Diamond.
Thiếu hụt không gian bộ nhớ tạm thời là nguyên nhân gốc rễ dẫn đến thất bại của Zero-shot. Khi không được kích hoạt chain of thought prompt, mô hình bị ép đưa ra kết luận ngay trong các token đầu tiên, hoàn toàn thiếu đi không gian để tự phản hồi, kiểm tra giả thuyết hoặc quay đầu sửa sai (backtracking).
Bản chất cơ chế suy luận từng bước (Chain-of-Thought) và góc nhìn về chain of thought prompt
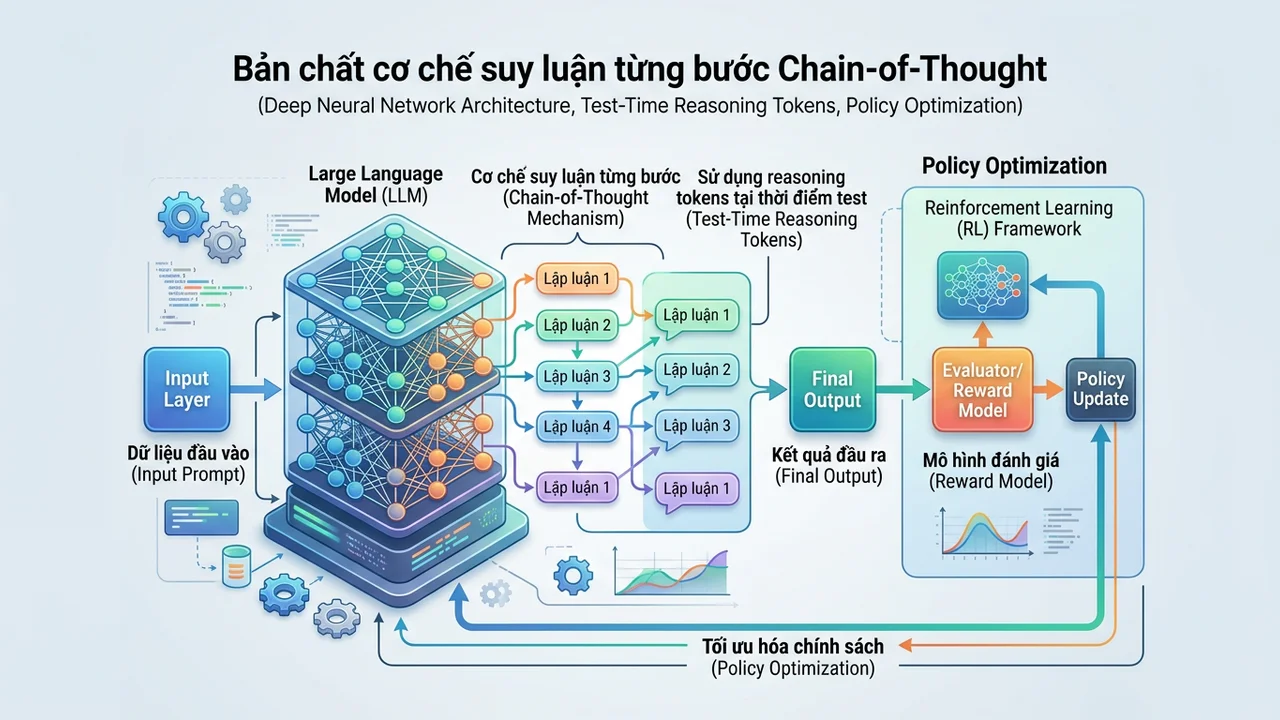
Cơ chế chain of thought prompt lần đầu được giới thiệu bởi Jason Wei và nhóm nghiên cứu Google Brain vào năm 2022, khởi đầu dưới dạng kỹ nghệ câu lệnh thủ công. Về bản chất toán học, phương pháp này mở rộng không gian tính toán thời gian thực (Test-time Compute) bằng cách ép mô hình sinh ra một chuỗi token trung gian phản ánh tiến trình tư duy.
Thay vì tính xác suất trực tiếp cho câu trả lời P(Answer | Prompt), mô hình sẽ tính toán tuần tự chuỗi suy luận P(Thought_1, Thought_2, ..., Thought_n | Prompt) rồi mới đi đến P(Answer | Thought_1...n, Prompt). Cơ chế này tạo điều kiện cho AI tự giám sát từng bước giải pháp, giảm thiểu tối đa các bước nhảy vọt vô căn cứ.
Hệ sinh thái AI hiện đại đã chuyển từ câu lệnh thủ công sang Native Chain-of-Thought thông qua huấn luyện tăng cường (Reinforcement Learning). Điển hình như DeepSeek-R1 với thuật toán GRPO (Group Relative Policy Optimization) hay Claude 3.7 Sonnet với kiến trúc Hybrid Reasoning, cho phép chuỗi suy luận kéo dài tới hàng chục nghìn tokens trước khi chốt kết quả.
| Tiêu chí so sánh | Kỹ nghệ Prompt CoT thủ công | Native CoT đóng (o1 / o3-mini) | Native CoT mở & lai (DeepSeek-R1 / Claude 3.7) |
|---|---|---|---|
| Cơ chế kích hoạt | Câu lệnh kích hoạt thủ công ("Think step by step") | Học tăng cường (RL), kích hoạt tự động | Kiến trúc suy luận lai kết hợp học tăng cường GRPO |
| Khả năng tự sửa sai | Thấp, dễ bị chệch hướng nếu bước đầu sai | Rất cao, tự lặp lại kiểm thử giả định | Rất cao, thể hiện rõ quá trình hoài nghi và sửa sai |
| Độ minh bạch | Hiển thị toàn bộ trong văn bản trả về | Ẩn chuỗi suy luận thô, chỉ tóm tắt | Hiển thị toàn bộ chuỗi token suy luận minh bạch |
| Kiểm soát tài nguyên | Phụ thuộc vào độ dài văn bản mẫu | Mức cố định (Low / Medium / High) | Tùy chỉnh chính xác ngân sách Token Budget |
Hướng dẫn cấu trúc Zero-shot CoT và Manual CoT
Trong hệ thống bài toán thực tế, việc phân định rõ từng dạng chain of thought prompt là yêu cầu bắt buộc khi lập trình hệ thống agent. Tùy thuộc vào cấp độ bài toán trong bảng phân loại cấp độ prompt, người dùng có thể áp dụng Zero-shot CoT hoặc Manual/Few-shot CoT để đạt hiệu quả cao nhất.
Kỹ thuật Zero-shot CoT
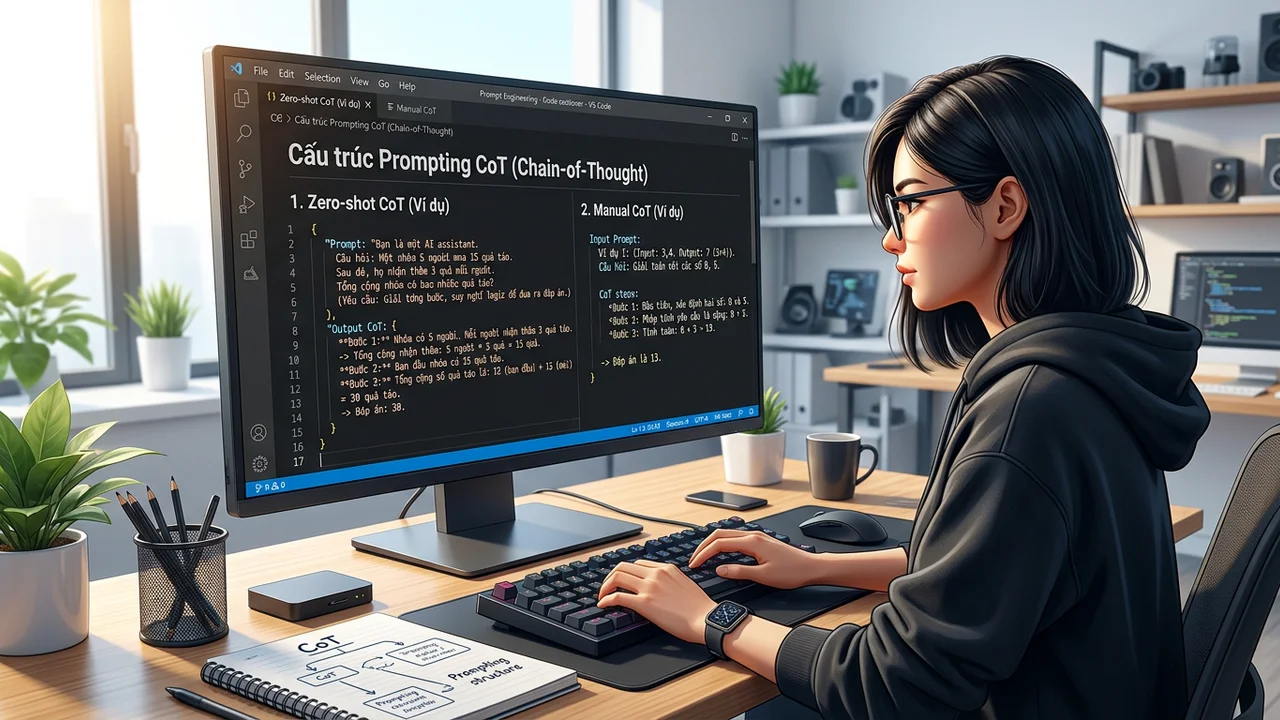
Zero-shot CoT là kỹ thuật đơn giản nhất bằng cách gắn mệnh đề định hướng suy luận vào cuối câu lệnh. Mẫu câu lệnh kinh điển "Hãy suy nghĩ từng bước một một cách cẩn trọng" (Let's think step by step) kích hoạt các vùng trọng số giải thích bên trong mô hình, buộc hệ sinh thái token đầu ra phải trải qua giai đoạn lập luận.
Mặc dù dễ triển khai, Zero-shot CoT phụ thuộc hoàn toàn vào khả năng tiền huấn luyện sẵn có của LLM. Kỹ thuật này phát huy tác dụng mạnh nhất trên các tác vụ phân tích văn bản logic cơ bản nhưng có thể thiếu chính xác khi xử lý dữ liệu đặc thù doanh nghiệp.
Kỹ thuật Few-shot Manual CoT
Manual CoT yêu cầu người dùng cung cấp sẵn từ 2 đến 3 cặp mẫu (Example pairs) hoàn chỉnh, bao gồm câu hỏi, tiến trình phân tích cụ thể và đáp án cuối cùng. Đây là phương thức chuẩn mực để định hình cách tư duy của mô hình theo đúng cấu trúc dữ liệu mong muốn.
Dưới đây là một cấu trúc chuẩn áp dụng mẫu chain of thought prompt trong môi trường phân tích dữ liệu:
[BÀI TOÁN MẪU]
Đầu vào: Server A có CPU 80%, Memory 90%. Server B có CPU 30%, Memory 40%. Nếu chuyển tải 25% từ Server A sang Server B, tải mới của từng server là bao nhiêu?
Tiến trình tư duy:
Bước 1: Tính toán lượng tải cần điều chuyển khỏi Server A: 80% * 0.25 = 20% CPU; 90% * 0.25 = 22.5% Memory.
Bước 2: Cập nhật trạng thái Server A: CPU = 80 - 20 = 60%; Memory = 90 - 22.5 = 67.5%.
Bước 3: Cập nhật trạng thái Server B: CPU = 30 + 20 = 50%; Memory = 40 + 22.5 = 62.5%.
Kết luận: Server A (CPU 60%, RAM 67.5%), Server B (CPU 50%, RAM 62.5%).

[BÀI TOÁN THỰC TẾ]
Đầu vào: [Dữ liệu hệ thống cần xử lý hiện tại]
Phương pháp này đặc biệt hữu dụng khi xây dựng các tác vụ chuyên biệt, tương tự kỹ thuật được áp dụng trong bài viết prompt cho lập trình viên nhằm chuẩn hóa quy trình phân tích mã nguồn và kiểm thử hệ thống tự động.
Kỹ thuật Tree of Thoughts (ToT) khám phá nhiều nhánh quyết định
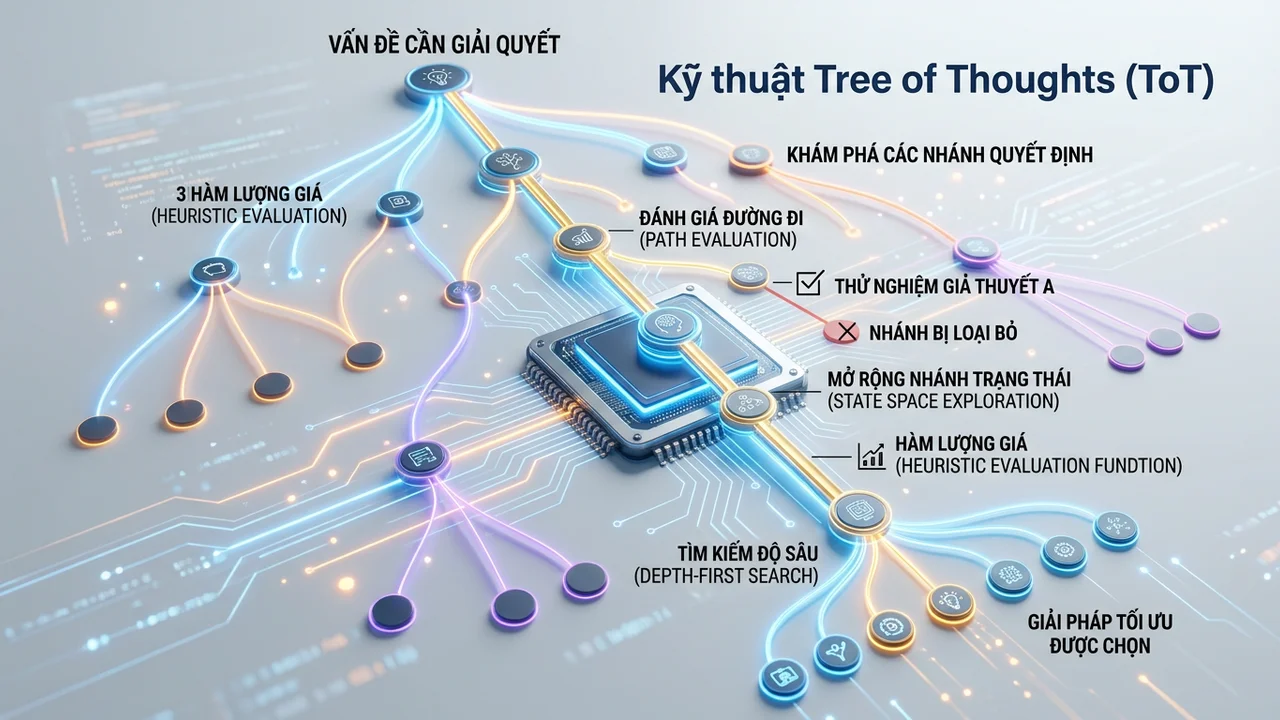
Mặc dù chain of thought prompt tuyến tính giải quyết tốt các bài toán logic một chiều, nó vẫn gặp khó khăn trước các bài toán đòi hỏi tầm nhìn chiến lược hoặc cần thăm dò nhiều khả năng song song. Tree of Thoughts (ToT) là bước tiến hóa trực tiếp từ CoT, cho phép mô hình duy trì một cây phân nhánh các suy nghĩ.
Trong cấu trúc ToT, mỗi nút trên cây đại diện cho một bước tư duy trung gian độc lập. Hệ thống kết hợp các thuật toán tìm kiếm cổ điển như Breadth-First Search (BFS) hoặc Depth-First Search (DFS) để định giá tiềm năng của từng nhánh suy luận thông qua cơ chế tự chấm điểm (Self-evaluation).
- Khởi tạo suy nghĩ (Thought Generation): Sinh ra 3 đến 5 hướng tiếp cận khác nhau cho vấn đề ban đầu thay vì đi theo một mạch duy nhất.
- Đánh giá trạng thái (State Evaluation): Mô hình đóng vai trò giám sát, chấm điểm xác suất thành công của từng hướng đi theo thang điểm logic.
- Duyệt cây và Quay lui (Backtracking): Nếu một nhánh suy luận đi vào ngõ cụt hoặc vi phạm ràng buộc kỹ thuật, mô hình tự động lùi về nút trước đó để khai thác nhánh tiềm năng thay thế.
Sự kết hợp giữa chain of thought prompt và thuật toán duyệt cây biến AI thành một công cụ giải quyết bài toán tối ưu hóa tổ hợp, thiết kế thuật toán hay phân tích kịch bản kinh doanh đa chiều mà chuỗi suy luận đơn luồng không thể xử lý.
Ứng dụng CoT trong dự báo tài chính và kiến trúc hệ thống
Trong phân tích tài chính doanh nghiệp, việc dự phóng dòng tiền đòi hỏi liên kết chặt chẽ giữa các chỉ số vĩ mô, lãi suất và chi phí vốn. Sử dụng chain of thought prompt giúp quy trình thẩm định ngân sách bóc tách chi tiết từng giả định tăng trưởng, phản ánh biến số rủi ro trước khi đưa ra khuyến nghị đầu tư.
Chuỗi suy luận buộc mô hình phải kiểm tra chéo tính cân bằng giữa bảng cân đối kế toán và báo cáo lưu chuyển tiền tệ. Khi phát hiện chênh lệch, các mô hình Native CoT như DeepSeek-R1 có khả năng tự quay lại rà soát công thức tính khấu hao hoặc chi phí lãi vay, nâng tỷ lệ chính xác của mô hình dự báo lên mức cao nhất.
Đối với thiết kế kiến trúc phần mềm phân tán, kỹ thuật chain of thought prompt đóng vai trò nòng cốt trong việc đánh giá các kịch bản chịu tải, phân vùng cơ sở dữ liệu và cân nhắc các ràng buộc trong định lý CAP. Kỹ sư có thể yêu cầu mô hình phản biện đa chiều về tính khả thi của kiến trúc microservices so với monolithic trước khi viết mã.
Mô hình có thể mô phỏng quy trình xử lý lỗi mạng từng bước: từ điểm nghẽn của API Gateway, độ trễ phân tán đến cơ chế phục hồi dữ liệu tại các cụm cơ sở dữ liệu.
Nhờ cơ chế kiểm soát ngân sách suy luận (Thinking Budget) trên các nền tảng như Claude 3.7 Sonnet hay OpenAI o3-mini, đội ngũ kỹ thuật có thể tối ưu chi phí hạ tầng mà vẫn bảo đảm độ tin cậy của bản thiết kế.
Câu hỏi thường gặp (FAQ)
Khi nào nên dùng Zero-shot CoT thay vì Native CoT như DeepSeek-R1?
Zero-shot CoT thủ công phù hợp khi làm việc với các mô hình ngôn ngữ truyền thống (như GPT-4o, Claude 3.5 Sonnet) để giải quyết bài toán mức độ trung bình với độ trễ thấp. Với các bài toán logic cấp tiến sĩ hoặc giải thuật thi đấu, việc dùng trực tiếp các mô hình Native CoT như DeepSeek-R1 hay o3-mini mang lại độ chuẩn xác vượt trội.
Kỹ thuật chain of thought prompt có làm tăng chi phí API không?
Có. Chi phí API tỷ lệ thuận với số lượng token đầu ra. Chuỗi suy luận có thể tiêu tốn từ vài trăm đến hàng chục nghìn tokens tư duy bổ sung. Tuy nhiên, mức giá tối ưu từ các nền tảng như DeepSeek-R1 (~$2.19/1M output tokens bao gồm cả reasoning tokens) đã giảm thiểu đáng kể rào cản chi phí này.
Làm sao để hạn chế tình trạng AI suy luận sai ở các bước đầu tiên?
Giải pháp hiệu quả nhất là kết hợp Few-shot CoT với các bước kiểm tra chéo (Verification steps). Bổ sung chỉ dẫn yêu cầu mô hình xác thực tính hợp lệ của dữ liệu trước khi chuyển sang bước tính toán kế tiếp nhằm dập tắt hiện tượng ảo giác dây chuyền.
Lời kết
Kỹ thuật chain of thought prompt đã hoàn tất hành trình tiến hóa từ một thủ thuật kỹ nghệ câu lệnh thành nền móng kiến trúc của các thế hệ AI suy luận hiện đại. Việc thấu hiểu cơ chế phân rã logic và điều phối ngân sách tính toán suy luận là lợi thế cạnh tranh cốt lõi cho mọi kỹ sư công nghệ.
Để tối ưu hóa quy trình triển khai chain of thought prompt trong các hệ thống ứng dụng thực tế, hãy áp dụng bảng kiểm định kỹ thuật sau:
- Xác định chính xác độ phức tạp của tác vụ: chỉ kích hoạt CoT cho các bài toán từ 2 tầng logic trở lên.
- Chọn mô hình phù hợp: sử dụng Native CoT (DeepSeek-R1, o3-mini, Claude 3.7) cho toán học và mã nguồn; dùng Few-shot CoT trên các LLM tiêu chuẩn cho bài toán nghiệp vụ riêng biệt.
- Cấu hình Thinking Budget hợp lý để cân đối giữa chi phí token và độ chính xác của kết quả.
- Xây dựng bước kiểm thử độc lập cho từng mắt xích tư duy nhằm ngăn chặn sai lệch logic dây chuyền.
Bình luận