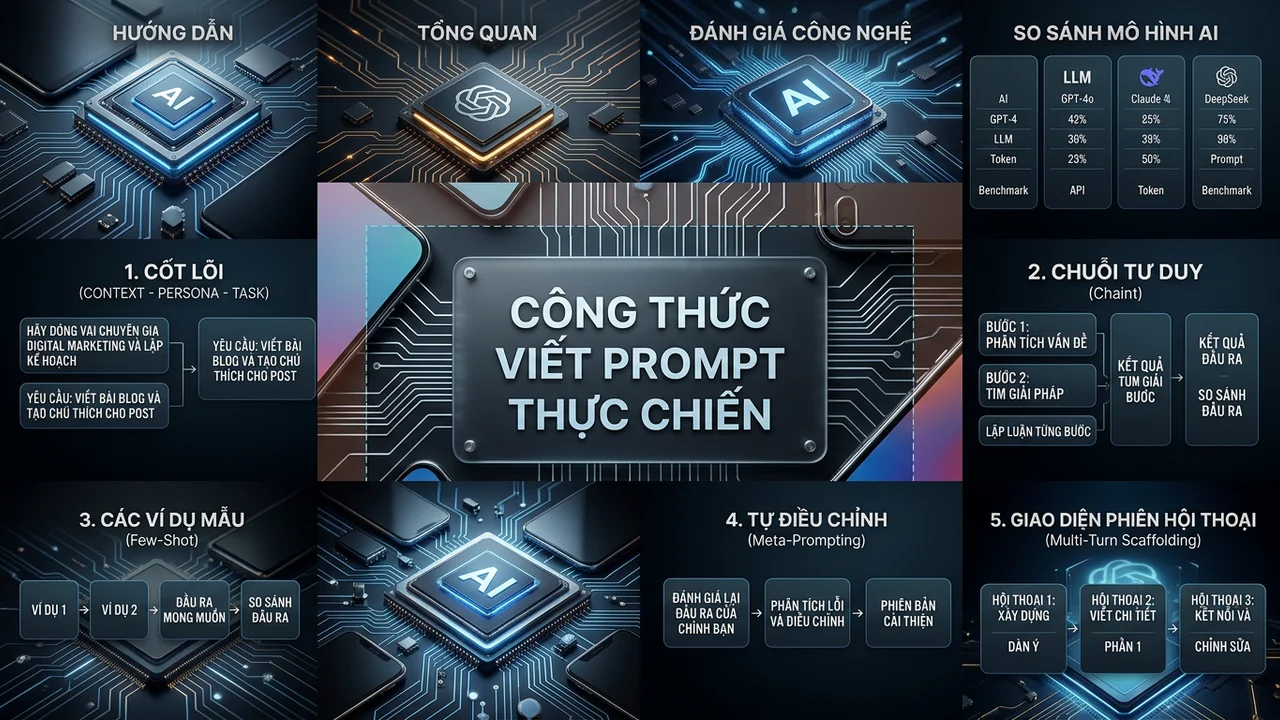
Nhiều kỹ sư và chuyên viên triển khai AI thường xuyên gặp phải tình trạng mô hình trả lời lan man, sai lệch định dạng JSON hoặc bịa đặt thông tin khi xử lý các nghiệp vụ phức tạp. Việc áp dụng đúng công thức viết prompt theo tiêu chuẩn kỹ thuật hiện đại chính là giải pháp dứt điểm để kiểm soát tính ổn định của đầu ra dữ liệu.
Kỹ thuật giao tiếp với mô hình ngôn ngữ lớn (LLM) đã chuyển dịch rõ rệt từ việc gõ văn bản cảm tính sang kỹ thuật quản trị ngữ cảnh (Context Engineering). Khi xây dựng hệ thống tự động hóa hoặc tích hợp API, nắm vững các công thức viết prompt chuẩn xác giúp giảm thiểu tỷ lệ lỗi định dạng và tối ưu hóa tài nguyên tính toán hiệu quả.
Hệ thống hướng dẫn dưới đây từ thanhtuan.vn tổng hợp các kiến trúc câu lệnh thực chiến nhất, giúp người triển khai kiểm soát chặt chẽ hành vi của các mô hình hàng đầu như GPT-4o, Claude 3.5 Sonnet hay DeepSeek-R1.
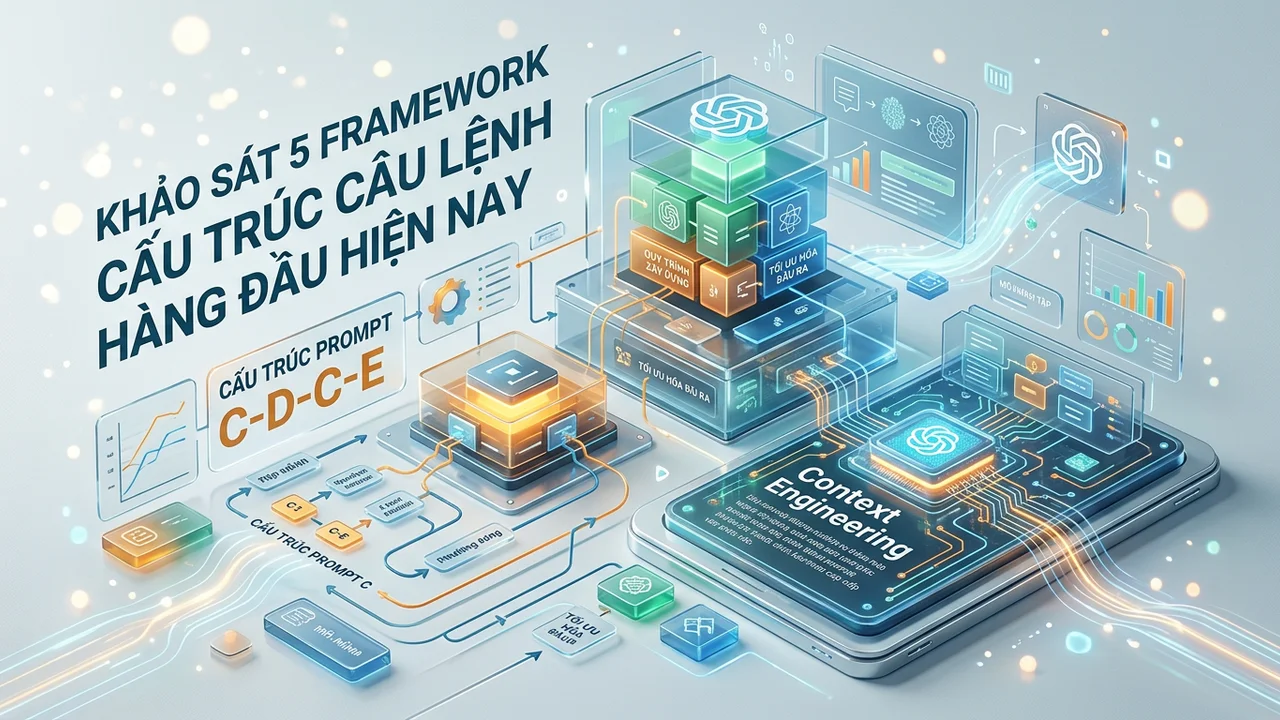
Khảo sát 5 framework cấu trúc câu lệnh hàng đầu hiện nay và góc nhìn về công thức viết prompt
Các câu lệnh rời rạc không còn phù hợp với các pipeline tự động hóa phức tạp. Mỗi công thức viết prompt dưới đây được thiết kế nhằm giải quyết triệt để từng bài toán nghiệp vụ từ đơn giản đến chuyên sâu.
1. Framework C-D-C-E (Context – Decision Flow – Constraints – Evaluation)
Mô hình C-D-C-E thay thế hoàn toàn cấu trúc Role-Task truyền thống bằng cách tập trung vào logic rẽ nhánh nghiệp vụ. Cấu trúc này gồm 4 khối thành phần mạch lạc:
- Context (Ngữ cảnh): Thiết lập biến môi trường và dữ liệu thô đầu vào.
- Decision Flow (Cây quyết định): Định nghĩa logic If-Else rõ ràng để điều phối hành vi suy luận.
- Constraints (Rào chắn ràng buộc): Thiết lập các giới hạn phủ định mà AI tuyệt đối không được vi phạm.
- Evaluation (Tiêu chuẩn nghiệm thu): Bộ tiêu chí để mô hình tự kiểm tra tính hợp lệ trước khi hoàn tất phản hồi.
Một mẫu áp dụng công thức viết prompt C-D-C-E thực tế: [CONTEXT]: Dữ liệu log giao dịch API thanh toán... [DECISION FLOW]: Nếu mã lỗi 502 hoặc 504, phân loại Incident Tier 1; nếu mã lỗi 400, phân loại Tier 3. [CONSTRAINTS]: Không giả định nguyên nhân ngoài log; không làm tròn dấu thập phân. [EVALUATION]: Trả về JSON hợp lệ với 4 trường: id, tier, reason, timestamp.
2. Framework CoD (Chain-of-Density)
Chain-of-Density là phương pháp tối ưu hóa việc nén thông tin, đặc biệt hiệu quả khi cần tóm tắt tài liệu kỹ thuật hoặc báo cáo phân tích. Mô hình sẽ tạo ra một bản tóm tắt ngắn, sau đó trải qua từ 3 đến 5 vòng lặp để bổ sung các thực thể còn thiếu mà không làm gia tăng độ dài của văn bản.
Việc áp dụng công thức viết prompt CoD giúp loại bỏ hoàn toàn các từ đệm sáo rỗng, tạo ra đầu ra có mật độ tri thức cực cao, phù hợp cho luồng tổng hợp dữ liệu điều hành.
3. Framework ReAct Strict Schema
ReAct (Reasoning and Acting) kết hợp khả năng suy luận logic với việc kích hoạt các công cụ ngoại vi. Khi kết hợp với cấu trúc JSON Schema nghiêm ngặt, ReAct biến các mô hình ngôn ngữ thành các AI Agent thực thụ có khả năng tự động thực thi tác vụ.
4. Framework Contrastive Few-Shot
Thay vì chỉ đưa ra ví dụ chuẩn mực, phương pháp này cung cấp đồng thời cả ví dụ đạt yêu cầu lẫn ví dụ sai kèm lời giải thích cụ thể. Cách làm này giúp mô hình nhận diện chính xác các trường hợp biên khó nhằn trong tác vụ kiểm duyệt nội dung.
5. Framework Declarative Meta-Prompting
Được thiết kế riêng cho các mô hình lập luận chuyên sâu như o1, o3-mini hay DeepSeek-R1, framework này tập trung khai báo mục tiêu tối hậu và rào cản thay vì hướng dẫn từng bước. Nhờ đó, cơ chế Test-Time Compute nội tại của mô hình được kích hoạt tối đa.
Phân tích cơ chế hoạt động của Zero-shot và Few-shot Prompting
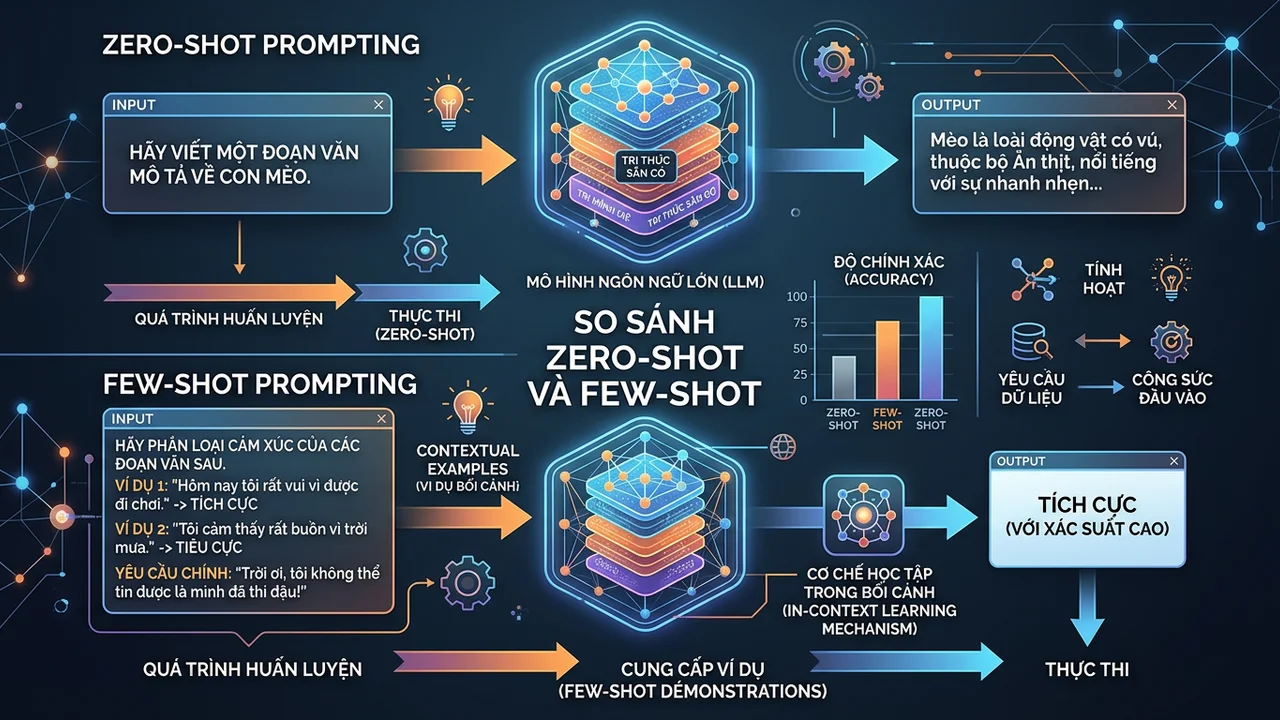
Hiểu rõ nguyên lý hoạt động của Zero-shot và Few-shot Prompting là nền tảng cốt lõi trước khi áp dụng bất kỳ công thức viết prompt nâng cao nào vào hệ thống.
Kỹ thuật Zero-shot dựa hoàn toàn vào tri thức đã học trong giai đoạn huấn luyện của mô hình. Kỹ sư gửi trực tiếp yêu cầu xử lý mà không đính kèm bất kỳ ví dụ mẫu nào. Cách tiếp cận này tiết kiệm token đầu vào nhưng tỷ lệ trôi định dạng rất cao khi xử lý dữ liệu phức tạp.
Ngược lại, Few-shot Prompting cung cấp cho mô hình từ 2 đến 5 cặp dữ liệu mẫu (Input – Output). Mô hình sử dụng cơ chế In-Context Learning để nhận diện cấu trúc, phong cách biểu đạt và quy chuẩn phản hồi mong muốn.
Bạn có thể tham khảo thêm nhiều cấu trúc ngữ cảnh chuyên sâu tại thư viện prompt AI để tối ưu hóa quá trình thiết kế câu lệnh cho đội ngũ kỹ thuật.
Triển khai kỹ thuật ReAct kết hợp suy luận và hành động ngoại vi
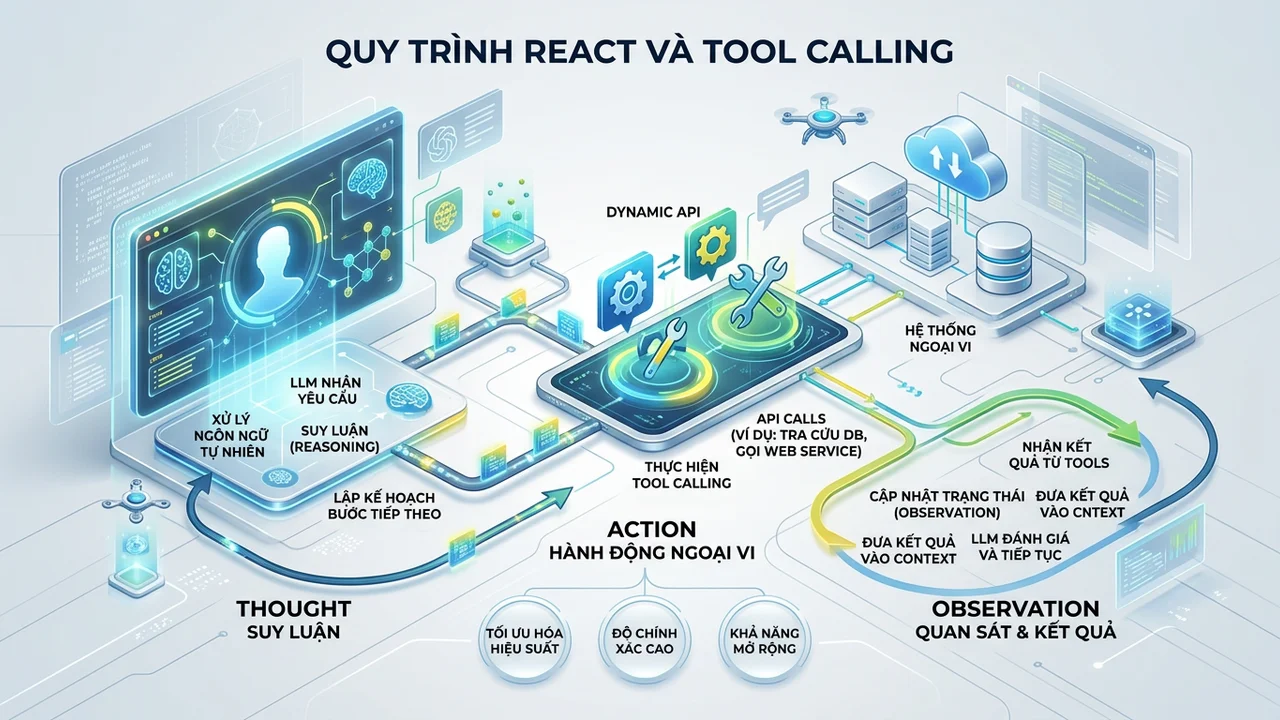
Kỹ thuật ReAct đóng vai trò trụ cột trong việc phát triển AI Agent tự chủ. Khi tích hợp vào môi trường API, một công thức viết prompt ReAct hoàn chỉnh phải tuần tự kích hoạt 4 trạng thái cốt lõi.
Khối trạng thái đầu tiên là Thought, nơi mô hình phân tích ngữ cảnh hiện tại và xác định dữ liệu còn thiếu. Ngay sau đó, khối Action được sinh ra dưới định dạng Tool Call chuẩn, chỉ định tên hàm cùng tham số tương ứng.
Hệ thống Backend tiếp nhận yêu cầu, thực thi truy vấn và trả dữ liệu ngược lại cho mô hình dưới dạng Observation. Chu trình này lặp lại liên tục cho đến khi tác nhân có đủ dữ kiện để tạo ra Final Answer cho người dùng.
Để vận hành ổn định trong production, toàn bộ các lượt gọi hành động cần được ràng buộc bằng Structured Outputs. Điều này đảm bảo phản hồi luôn khớp với JSON Schema và không làm gãy pipeline của ứng dụng.
Ứng dụng Directional Stimulus để điều hướng trọng tâm phản hồi
Directional Stimulus Prompting (DSP) là kỹ thuật cung cấp thêm một gợi ý định hướng cụ thể (Hint hoặc Trigger) nhằm điều khiển trọng tâm câu trả lời của mô hình mà không cần viết lại toàn bộ câu lệnh gốc.
Trong xử lý ngôn ngữ tự nhiên, các mô hình lớn dễ bị chi phối bởi các từ khóa xuất hiện ở phần đầu văn bản dài. Áp dụng công thức viết prompt có chứa tín hiệu kích thích định hướng giúp ghim sự chú ý của mô hình vào đúng điểm nghẽn nghiệp vụ quan trọng.
Ví dụ, khi trích xuất rủi ro từ một bản hợp đồng mua bán thiết bị, câu gợi ý định hướng có thể ghi rõ: [DIRECTIONAL STIMULUS]: Tập trung toàn bộ vào điều khoản phạt vi phạm giao hàng chậm và giới hạn trách nhiệm bồi thường.
Tín hiệu điều hướng ngắn gọn này giúp bộ giải mã (decoder) của mô hình ưu tiên phân bổ trọng số vào các token liên quan đến pháp lý và tài chính, bỏ qua các điều khoản hành chính thông thường.
Bảng tổng kết kịch bản lựa chọn framework phù hợp theo độ phức tạp
Mỗi bài toán triển khai đòi hỏi một cách tiếp cận khác biệt để cân đối giữa chi phí tính toán và chất lượng dữ liệu. Dưới đây là bảng đối chiếu chi tiết giữa phương pháp truyền thống và hiện đại.
| Tiêu chí kỹ thuật | Tiếp cận Cổ điển (2022 – 2024) | Kỹ thuật Ngữ cảnh Hiện đại (2025 – 2026) |
|---|---|---|
| Bản chất câu lệnh | Ghép chuỗi văn bản cảm tính, lạm dụng vai trò giả lập. | Cấu trúc hóa ngữ cảnh, phân tầng bộ nhớ và tích hợp Tool Calling. |
| Định dạng đầu ra | Định dạng tự do, dễ lệch chuẩn định dạng khi chạy tự động. | Tuân thủ nghiêm ngặt chuẩn Strict JSON Schema xác định 100%. |
| Tối ưu chi phí API | Gửi lại toàn bộ ngữ cảnh mỗi lượt tương tác, gây lãng phí. | Tận dụng Prompt Caching, giảm tới 80% độ trễ và 90% chi phí input token. |
| Xử lý tác vụ phức tạp | Bắt chước suy nghĩ thủ công bằng câu thần chú Think step by step. | Khai thác Reasoning Models chuyên sâu (o1, o3-mini, DeepSeek-R1). |
| Độ ổn định hệ thống | Dễ sai lệch khi thay đổi từ ngữ nhỏ trong câu lệnh. | Tự động hóa kiểm thử và tối ưu qua framework chuyên dụng (DSPy). |
Đối với các tác vụ phân tích tài chính hoặc truy xuất dữ liệu doanh nghiệp, việc áp dụng đúng công thức viết prompt kết hợp tính năng Prompt Caching trên Claude 3.5 Sonnet hoặc GPT-4o giúp doanh nghiệp tiết kiệm hàng nghìn USD chi phí vận hành mỗi tháng.
Câu hỏi thường gặp (FAQ) và góc nhìn về công thức viết prompt
Có nên dùng câu lệnh Hãy suy nghĩ từng bước với các mô hình lập luận mới không?
Tuyệt đối không nên sử dụng. Các mô hình như o1, o3-mini hay DeepSeek-R1 đã tích hợp sẵn cơ chế lập luận Test-Time Compute bên trong. Việc gượng ép chèn câu lệnh CoT thủ công sẽ làm loãng luồng tư duy nội tại của mô hình và gây lãng phí token suy luận không cần thiết.
Làm thế nào để đảm bảo mô hình luôn trả về định dạng JSON hợp lệ?
Cần sử dụng tính năng Structured Outputs với cờ strict: true trên API của OpenAI hoặc tool-use schema của Anthropic. Kết hợp thêm công thức viết prompt C-D-C-E với khối Constraints rõ ràng để loại bỏ hoàn toàn các ký tự Markdown thừa bên ngoài chuỗi JSON.
Prompt Caching mang lại lợi ích gì cho hệ sinh thái AI Agent?
Prompt Caching cho phép lưu đệm các đoạn ngữ cảnh tĩnh (như tài liệu hướng dẫn, schema công cụ) từ 1.024 token trở lên. Cơ chế này giúp giảm tới 80% độ trễ phản hồi (TTFT) và cắt giảm từ 50% đến 90% chi phí tính toán cho mỗi yêu cầu lặp lại.
Lời kết và góc nhìn về công thức viết prompt
Để triển khai các công thức viết prompt đạt hiệu quả cao nhất trên hệ thống thực tế, đội ngũ kỹ thuật cần thực hiện các bước chuẩn hóa sau:
- Rà soát lại toàn bộ kho prompt hiện tại: Loại bỏ ngay các câu lệnh cảm tính rườm rà và thay thế bằng các khối logic C-D-C-E hoặc ReAct rõ ràng.
- Kích hoạt Prompt Caching: Phân tách ranh giới rõ ràng giữa system prompt tĩnh và biến số đầu vào của người dùng trên toàn bộ endpoint API.
- Áp dụng quy chuẩn Strict JSON Schema: Khóa chặt định dạng đầu ra của toàn bộ pipeline để ngăn chặn lỗi phân tích dữ liệu ở tầng Backend.
- Xây dựng bộ kiểm thử tự động (Evals): Thiết lập tập dữ liệu đối chuẩn nhằm đánh giá liên tục độ ổn định của câu lệnh trước khi đẩy lên production.
Bình luận