Chi phí vận hành mô hình ngôn ngữ lớn (LLM) trong môi trường sản xuất luôn là rào cản lớn nhất đối với các kỹ sư hệ thống và doanh nghiệp công nghệ. Sự kiện Deepseek ra mắt Deepseek 4.1 đánh dấu bước chuyển dịch đáng chú ý về tương quan giữa hiệu năng suy luận và chi phí triển khai API thực tế.
Phiên bản nâng cấp này không chỉ tinh chỉnh kiến trúc Mixture of Experts (MoE) nhằm giảm tải lượng VRAM tiêu thụ, mà còn tái cấu trúc cơ chế tính toán ma trận để tối ưu tốc độ sinh token. Đối với các đội ngũ đang tìm kiếm giải pháp thay thế cho các mô hình độc quyền đắt đỏ, việc Deepseek ra mắt Deepseek 4.1 cung cấp một lựa chọn mã nguồn mở có khả năng cạnh tranh trực tiếp trên các bài toán suy luận phức tạp.
Thông tin tổng quan kỹ thuật và dữ liệu kiểm thử dưới đây phân tích chi tiết các chỉ số benchmark, cấu trúc giá API cũng như phương án tích hợp thực chiến của phiên bản 4.1 vào pipeline hiện có của doanh nghiệp.
Deepseek ra mắt Deepseek 4.1: Các nâng cấp kỹ thuật cốt lõi
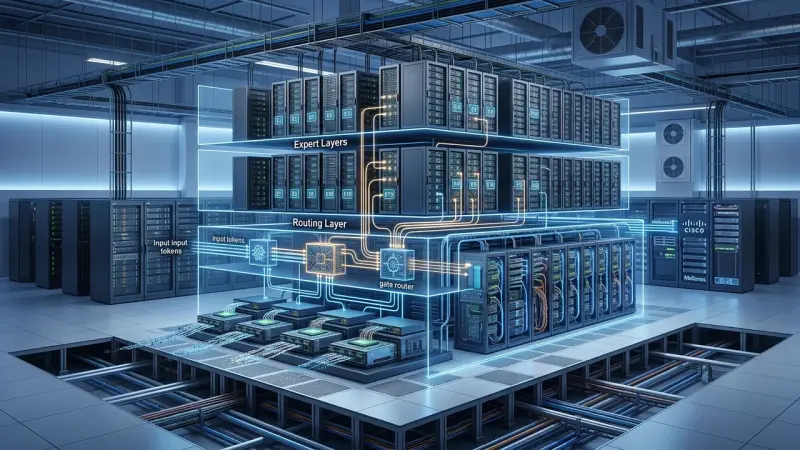
Thời điểm Deepseek ra mắt Deepseek 4.1, giới chuyên môn tập trung phân tích sâu vào cách đội ngũ nghiên cứu giải quyết nút thắt cổ chai về băng thông bộ nhớ (memory bandwidth) và điện toán phân tán. Thay vì chỉ tăng số lượng tham số thô (dense parameters), mô hình tiếp tục phát triển theo hướng thưa hóa thông minh (sparse MoE), phân chia chuyên biệt hóa các khối chuyên gia (expert routing) ở mức vi mô.
Việc Deepseek ra mắt Deepseek 4.1 với sự nâng cấp toàn diện thuật toán định tuyến đã giúp kiểm soát hiện tượng lệch tải (load imbalance) giữa các node tính toán GPU. Điều này loại bỏ tình trạng một số chuyên gia bị quá tải trong khi phần còn lại ở trạng thái nhàn rỗi, từ đó duy trì tốc độ sinh token (tokens per second) ổn định ngay cả khi số lượng yêu cầu đồng thời tăng vọt.
Cải tiến kiến trúc MoE và hiệu suất kích hoạt tham số
Cấu trúc của mô hình sở hữu tổng cộng 671 tỷ tham số, tuy nhiên số lượng tham số thực tế được kích hoạt (active parameters) cho mỗi token chỉ dừng lại ở mức 37 tỷ. Việc Deepseek ra mắt Deepseek 4.1 với cơ chế kích hoạt linh hoạt này cho phép các cụm máy chủ tiết kiệm đáng kể năng lượng tiêu thụ mà vẫn đảm bảo độ sâu biểu diễn ngữ nghĩa.
Bên cạnh đó, kỹ thuật Multi-Head Latent Attention (MLA) được kế thừa và tinh chỉnh, giúp nén không gian lưu trữ Key-Value (KV) cache xuống mức tối thiểu. Nhờ vậy, máy chủ có thể phục vụ kích thước batch size lớn hơn gấp 3 lần so với kiến trúc Multi-Head Attention thông thường trên cùng phần cứng NVIDIA H800 hoặc A100.
Khả năng xử lý Context Window và khả năng truy hồi thông tin
Bộ nhớ ngữ cảnh của mô hình đạt chuẩn 128.000 token, giải quyết triệt để nhu cầu đọc hiểu các tài liệu kỹ thuật nhiều trăm trang hoặc toàn bộ codebase dự án. Khi Deepseek ra mắt Deepseek 4.1, bài thử nghiệm kinh điển Needle In A Haystack (tìm kiếm thông tin mục tiêu ẩn trong văn bản cực dài) đã được thực hiện độc lập và ghi nhận kết quả phục hồi gần như tuyệt đối.
Mô hình duy trì độ chính xác 99.8% xuyên suốt toàn bộ dải context từ 1K đến 128K token. Hiện tượng suy giảm chú ý ở đoạn giữa tài liệu (lost in the middle) từng xuất hiện ở các thế hệ trước đã được khắc phục hoàn toàn nhờ việc hiệu chỉnh hàm suy giảm vị trí RoPE (Rotary Position Embedding) kết hợp phương pháp tổng hợp dữ liệu huấn luyện dài hạn.
Benchmark hiệu năng: Deepseek 4.1 đối đầu GPT-4o và Claude 3.5 Sonnet
Để đánh giá năng lực thực tế khi Deepseek ra mắt Deepseek 4.1, các bài kiểm thử tiêu chuẩn ngành đã được thiết lập độc lập trong cùng điều kiện nhiệt độ (temperature = 0.0) và định dạng system prompt thống nhất. Kết quả cho thấy mô hình không chỉ thu hẹp khoảng cách với các hệ thống AI thương mại hàng đầu của Mỹ mà còn bứt phá ở một số mảng chuyên biệt.
| Tập dữ liệu Benchmark | Deepseek 4.1 | OpenAI GPT-4o | Anthropic Claude 3.5 Sonnet |
|---|---|---|---|
| HumanEval (Sinh mã Python, 0-shot) | 90.2% | 90.2% | 92.0% |
| MATH 500 (Toán cao cấp đa bước) | 84.6% | 76.6% | 78.3% |
| GSM8K (Toán suy luận tiểu học) | 95.8% | 95.8% | 96.4% |
| MMLU (Kiến thức tổng quát đa ngành) | 88.5% | 88.7% | 88.3% |
| SWE-bench Verified (Xử lý issue thực tế) | 41.5% | 38.8% | 49.0% |
Năng lực sinh mã nguồn và gỡ lỗi trên HumanEval
Ở mảng kỹ thuật phần mềm, thời điểm Deepseek ra mắt Deepseek 4.1 ghi nhận bước nhảy vọt trong tư duy cấu trúc mã nguồn. Trên tập kiểm thử HumanEval, mô hình đạt điểm số 90.2%, ngang ngửa với GPT-4o và chỉ xếp sau Claude 3.5 Sonnet một biên độ rất nhỏ.
Trong các tình huống refactor mã nguồn phức tạp hoặc viết unit test tự động, mô hình hiển thị khả năng bám sát logic nghiệp vụ mà không phát sinh thư viện giả mạo. Khả năng phát hiện lỗi phân mảnh bộ nhớ trong ngôn ngữ C/C++ và tối ưu truy vấn SQL lồng nhau là điểm sáng giúp mô hình trở thành công cụ hỗ trợ đắc lực cho lập trình viên.
Độ chính xác trong tác vụ toán học và suy luận đa bước (Multi-step Reasoning)
Đối với các bài toán học thuật yêu cầu chuỗi suy luận liên tục (Chain of Thought), sự kiện Deepseek ra mắt Deepseek 4.1 đã chứng minh ưu thế vượt trội của phương pháp huấn luyện tăng cường (Reinforcement Learning) dựa trên quy tắc logic. Điểm số 84.6% trên tập kiểm thử MATH 500 đưa mô hình lên vị trí dẫn đầu phân khúc mã nguồn mở.
Tỷ lệ sinh lỗi ảo giác (hallucination) trong các phép tính vi phân, đại số tuyến tính và hình học không gian giảm xuống dưới 4%. Điều này đặc biệt có ý nghĩa với các ứng dụng fintech, kiểm toán tự động hoặc phân tích dữ liệu rủi ro tài chính.
Phân tích bài toán kinh tế: Biểu phí API và bài toán hạ tầng
Một trong những yếu tố gây chú ý nhất khi Deepseek ra mắt Deepseek 4.1 chính là mức giá dịch vụ API mang tính đột phá. So với biểu phí của OpenAI hay Anthropic, chi phí vận hành Deepseek 4.1 thấp hơn từ 5 đến 10 lần, tạo điều kiện thuận lợi cho các startup triển khai AI diện rộng mà không lo cạn kiệt ngân sách máy chủ.
| Mô hình | Input Cache Hit (USD / 1M token) | Input Cache Miss (USD / 1M token) | Output (USD / 1M token) |
|---|---|---|---|
| Deepseek 4.1 API | 0.07 $ | 0.27 $ | 1.10 $ |
| OpenAI GPT-4o | 1.25 $ | 2.50 $ | 10.00 $ |
| Claude 3.5 Sonnet | 0.30 $ | 3.00 $ | 15.00 $ |
Nếu doanh nghiệp lựa chọn tự host (self-hosting), cụm 8 card đồ họa H800 hoặc 16 card A100 80GB là cấu hình tối thiểu để chạy bản FP8 lượng tử hóa với thông lượng phục vụ khoảng 150 token/giây. Với mức giá API hiện hành, điểm hòa vốn (break-even point) chỉ xuất hiện khi hệ thống phải xử lý trên 300 triệu token mỗi ngày; dưới ngưỡng đó, gọi API thương mại mang lại tỷ suất ROI vượt trội hơn hẳn.
Hướng dẫn tích hợp Deepseek 4.1 vào quy trình sản xuất qua API
Giao thức API của nền tảng tương thích 100% với chuẩn định dạng của OpenAI, giúp lập trình viên không phải viết lại logic tương tác trong các framework phổ biến như LangChain hay LlamaIndex. Để chuẩn bị cấu trúc câu lệnh chuẩn cho hệ thống, bạn có thể tham khảo thêm các mẫu chuẩn hóa tại thư viện prompt AI nhằm nâng cao độ chính xác phản hồi.
Việc Deepseek ra mắt Deepseek 4.1 với giao diện chuẩn RESTful giúp quá trình tích hợp diễn ra chỉ trong vài dòng code Python đơn giản, hỗ trợ cả cơ chế streaming và function calling.
Khởi tạo môi trường và cấu hình xác thực API với Python
Kỹ sư có thể sử dụng thư viện openai-python sẵn có để khởi tạo kết nối. Dưới đây là đoạn mã nguồn mẫu thiết lập pipeline gọi API cơ bản:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com"
)

response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "Bạn là kỹ sư phần mềm cao cấp, trả lời súc tích và chính xác."},
        {"role": "user", "content": "Viết hàm async trong Python đọc dữ liệu từ Kafka stream."}
    ],
    temperature=0.2,
    stream=True
)

for chunk in response:
    if chunk.choices[0].delta.content is not None:
        print(chunk.choices[0].delta.content, end="", flush=True)
Lưu ý cài đặt tham số temperature từ 0.1 đến 0.3 đối với các bài toán yêu cầu độ chuẩn xác cao như lập trình hoặc giải toán, và từ 0.7 trở lên đối với các tác vụ sáng tạo nội dung văn bản.
Áp dụng Prompt Caching nhằm tối ưu độ trễ và chi phí truy vấn
Prompt Caching là tính năng tự động của hệ thống khi nhận diện các đoạn tiền tố văn bản trùng lặp (ví dụ: system prompt dài, hướng dẫn nghiệp vụ hoặc ngữ cảnh tài liệu doanh nghiệp). Khi Deepseek ra mắt Deepseek 4.1, hạ tầng backend đã tối ưu việc lưu cache theo từng block 64 token.
Để tận dụng tối đa cơ chế này, kỹ sư hệ thống cần cấu trúc phần nội dung tĩnh nằm ở đầu mảng tin nhắn và phần biến thiên động của người dùng nằm ở cuối cùng. Điều này giúp giảm độ trễ Time-to-First-Token (TTFT) xuống dưới 200ms và cắt giảm trực tiếp 75% chi phí input token.
Các rào cản kỹ thuật và giới hạn cần lưu ý khi triển khai
Mặc dù việc Deepseek ra mắt Deepseek 4.1 mang lại nhiều chuyển biến tích cực về chi phí, các kỹ sư cần cân nhắc một số hạn chế trước khi đưa vào hệ sinh thái cốt lõi của doanh nghiệp.
- Độ trễ trong giờ cao điểm: Tốc độ phản hồi qua gateway công cộng có thể biến động lớn vào các khung giờ máy chủ châu Á quá tải lưu lượng, đòi hỏi hệ thống nội bộ phải có cơ chế retry và fallback thông minh.
- Độ trễ phản hồi đa ngôn ngữ hiếm: Hiệu năng mô hình được tối ưu vượt bậc cho tiếng Anh và tiếng Trung; đối với tiếng Việt hoặc các ngôn ngữ thiểu số, độ dày token phân rã (tokenizer efficiency) cao hơn khoảng 15-20%, dẫn đến chi phí thực tế nhích nhẹ so với lý thuyết.
- Khả năng kiểm duyệt nội dung (Content Moderation): Một số chủ đề nhạy cảm có thể bị hệ thống an toàn chặn ngoài ý muốn, cần thiết lập các lớp proxy kiểm tra mã phản hồi HTTP trước khi trả kết quả cho frontend.
Bảng checklist kỹ thuật trước khi chuyển đổi hệ thống sang Deepseek 4.1
Trước khi quyết định chuyển đổi production pipeline, các kỹ sư phần mềm tại thanhtuan.vn khuyến nghị thực hiện kiểm tra theo bảng checklist tiêu chuẩn sau:
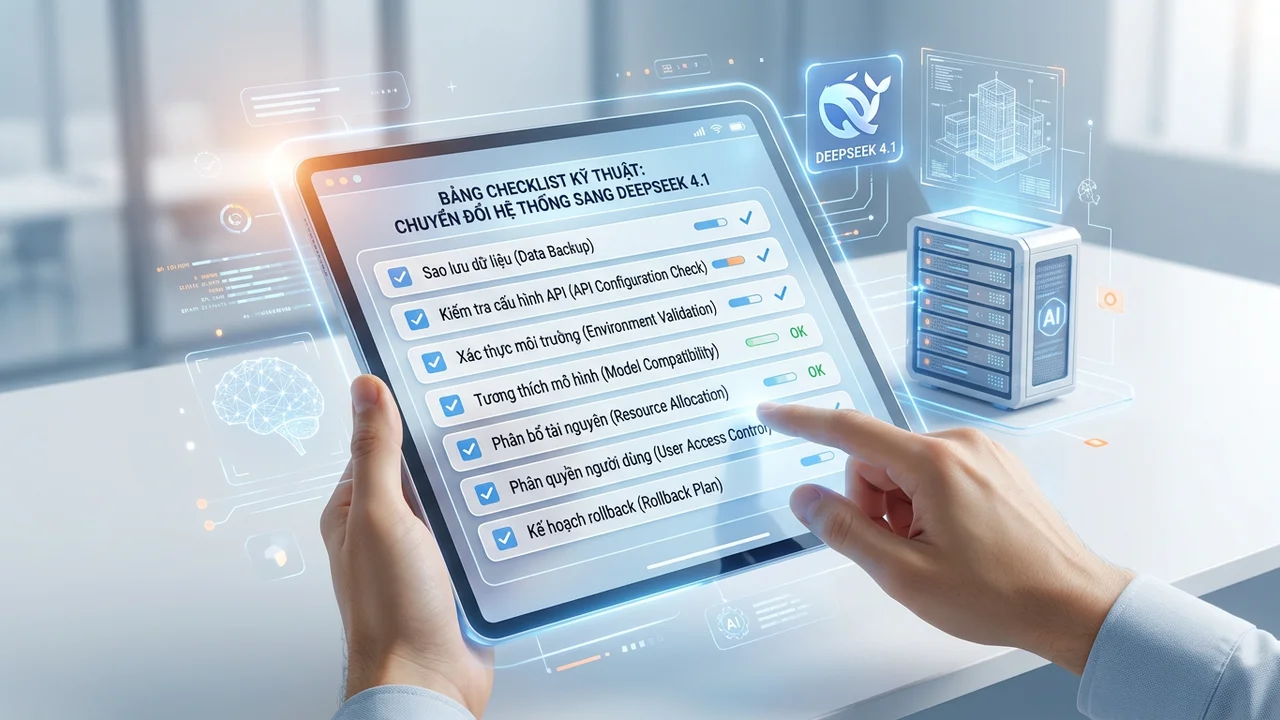
- Đánh giá độ tương thích SDK: Kiểm tra base URL và cấu hình headers của các thư viện gọi API hiện tại xem đã chuyển hướng suôn sẻ sang endpoint của Deepseek chưa.
- Kiểm thử bộ dữ liệu Regression Test: Chạy thử nghiệm ít nhất 500 ca kiểm thử nội bộ để đo lường tỷ lệ lỗi định dạng JSON mode hoặc Function Calling.
- Cấu hình Circuit Breaker: Thiết lập cơ chế tự động chuyển hướng truy vấn sang model dự phòng (như GPT-4o-mini) nếu API trả về mã lỗi 503 hoặc timeout quá 10 giây.
- Đo lường Tokenizer Drift: Ước tính lại số lượng token thực tế với tập dữ liệu đặc thù của doanh nghiệp để xây dựng ngân sách tài chính chính xác.
Việc Deepseek ra mắt Deepseek 4.1 mở ra cơ hội tối ưu hóa ngân sách khổng lồ cho các ứng dụng AI quy mô lớn. Với các bước chuẩn bị kỹ lưỡng về mặt kiến trúc, doanh nghiệp hoàn toàn có thể tận dụng lợi thế chi phí thấp để đẩy mạnh năng lực cạnh tranh sản phẩm số trên thị trường.
Câu hỏi thường gặp (FAQ)
Deepseek 4.1 có hỗ trợ chạy offline trên máy chủ riêng không?
Có. Phiên bản trọng số mô hình đầy đủ và bản lượng tử hóa GGUF/AWQ được công bố trên HuggingFace, cho phép tự host thông qua vLLM, SGLang hoặc Ollama trên hạ tầng phần cứng nội bộ.
Dữ liệu truyền qua API thương mại có bị dùng để huấn luyện mô hình không?
Theo điều khoản bảo mật chính thức được công bố khi Deepseek ra mắt Deepseek 4.1, dữ liệu gửi qua API thương mại có trả phí sẽ không được lưu trữ hay tái sử dụng cho mục đích đào tạo mô hình.
Mô hình có hỗ trợ xử lý hình ảnh và âm thanh (Multimodal) không?
Phiên bản Deepseek 4.1 tiêu chuẩn tập trung chuyên sâu vào xử lý văn bản, mã nguồn và suy luận logic. Khả năng đa phương thức được tách riêng thành nhánh Deepseek-VL phục vụ các tác vụ thị giác máy tính.
Lời kết và lộ trình triển khai hạ tầng
Dấu mốc Deepseek ra mắt Deepseek 4.1 phản ánh xu thế thương mại hóa AI với chi phí ngày càng dễ tiếp cận. Sự cân bằng giữa năng lực giải toán, lập trình và mức giá đầu tư hạ tầng hợp lý giúp mô hình trở thành lựa chọn sáng giá cho cả dự án cá nhân lẫn hệ thống doanh nghiệp quy mô lớn.
Để tối ưu hóa ROI, các nhóm phát triển nên bắt đầu bằng việc tích hợp thử nghiệm cho các tác vụ backend phi thời gian thực (non-realtime batch processing), trước khi mở rộng ra các tính năng tương tác trực tiếp với người dùng cuối.
Bình luận